
Promptgids
Zo schrijf je prompts voor MOSS-Image
MOSS-Image promptgids: zo schrijf je prompts voor MOSS-Image met lange beschrijvingen, exacte Engelse en Chinese tekst, layoutprompts en prompts om te kopiëren.
Snel aan de slag
Je eerste sterke prompt voor MOSS-Image
Alles wat je als beginner nodig hebt in één minuut: wat je eerst moet weten, de belangrijkste regels, een sjabloon om in te vullen en prompts om te kopiëren.
Wat je eerst moet weten
MOSS-Image is gemaakt voor lange, uitgebreide prompts: het leest een hele alinea en volgt die nauwgezet, dus met een prompt van één regel verspil je het. Beschrijf het beeld in gewone zinnen: het onderwerp en wat het doet, de omgeving, de camera, het medium, het licht, de materialen en de kleuren. Zet woorden die in de afbeelding moeten staan tussen dubbele aanhalingstekens. Het maakt afbeeldingen alleen op basis van tekst, dus je hoeft niets te uploaden, en formaat en beeldverhouding zijn instellingen.
De belangrijkste regels
Beschrijf alles
Onderwerp en actie, omgeving, camera en kadrering, medium, licht, materialen en kleurenpalet. Wat je weglaat, beslist MOSS-Image voor je, dus een volledige alinea werkt beter dan een korte zin.
Citeer de exacte woorden
Zet tekst tussen dubbele aanhalingstekens, precies zoals die moet staan, met plek en uiterlijk: a chalkboard sign by the door that reads "FRESH COFFEE $3" in white hand-lettered capitals.
Schrijf de prompt in het Engels
Engels geeft de beste resultaten. Zet tekst die in beeld moet komen binnen de aanhalingstekens in de eigen taal, zoals een Chinees winkelbord in een Engelse beschrijving.
Gebruik de negatieve prompt voor wat steeds terugkomt
Een korte lijst zoals "worst quality, bad anatomy, watermark, jpeg artifact" maakt de meeste afbeeldingen schoner. De hoofdprompt beschrijft alleen wat je wilt.
Laat Prompt Enhance uit
Het voegt willekeurige woorden toe aan het eind van je prompt. Een uitgebreide MOSS-Image-prompt werkt beter zoals jij hem hebt geschreven.
Vul dit sjabloon in
Vervang elk onderdeel tussen vierkante haken door je eigen idee en laat een onderdeel weg als je het niet nodig hebt.
[Subject doing what] in [setting]. [Other details, each in its place]. [Any text, in double quotes, and where it appears]. [Medium], [camera and framing]. [Light and its source]. [Palette and mood].A street cook in a red apron tosses noodles in a smoking wok at a crowded night market stall. Steam rises past paper lanterns strung overhead; on the left, a line of customers waits under a striped awning. A hand-painted wooden sign above the stall reads "LATE NIGHT NOODLES" in bold yellow letters. Photo, eye level, 35mm, shallow depth of field. Warm light from the lanterns and a cold blue glow from the street behind. Amber and teal palette, busy and cheerful.[Subject doing what]Wie of wat er in beeld is, met de actie: a street cook in a red apron tosses noodles in a smoking wok.[setting]Waar en wanneer: a crowded night market stall.[Other details, each in its place]Al het andere in beeld, met woorden geplaatst: on the left, overhead, in the foreground.[Any text, in double quotes, and where it appears]De exacte woorden en hoe ze eruitzien: a hand-painted sign above the stall reads "LATE NIGHT NOODLES". Laat dit weg als er geen tekst in beeld moet.[Medium]Wat voor afbeelding het is: photo, 35mm film photograph, watercolor illustration, flat vector poster.[camera and framing]Vanaf waar we kijken: eye level, a wide shot, a close-up from slightly below.[Light and its source]Waardoor de scène wordt verlicht: warm light from paper lanterns overhead.[Palette and mood]De hoofdkleuren en het gevoel: amber and teal, busy and cheerful.
Prompts om mee te beginnen
Een bord in een echte scène
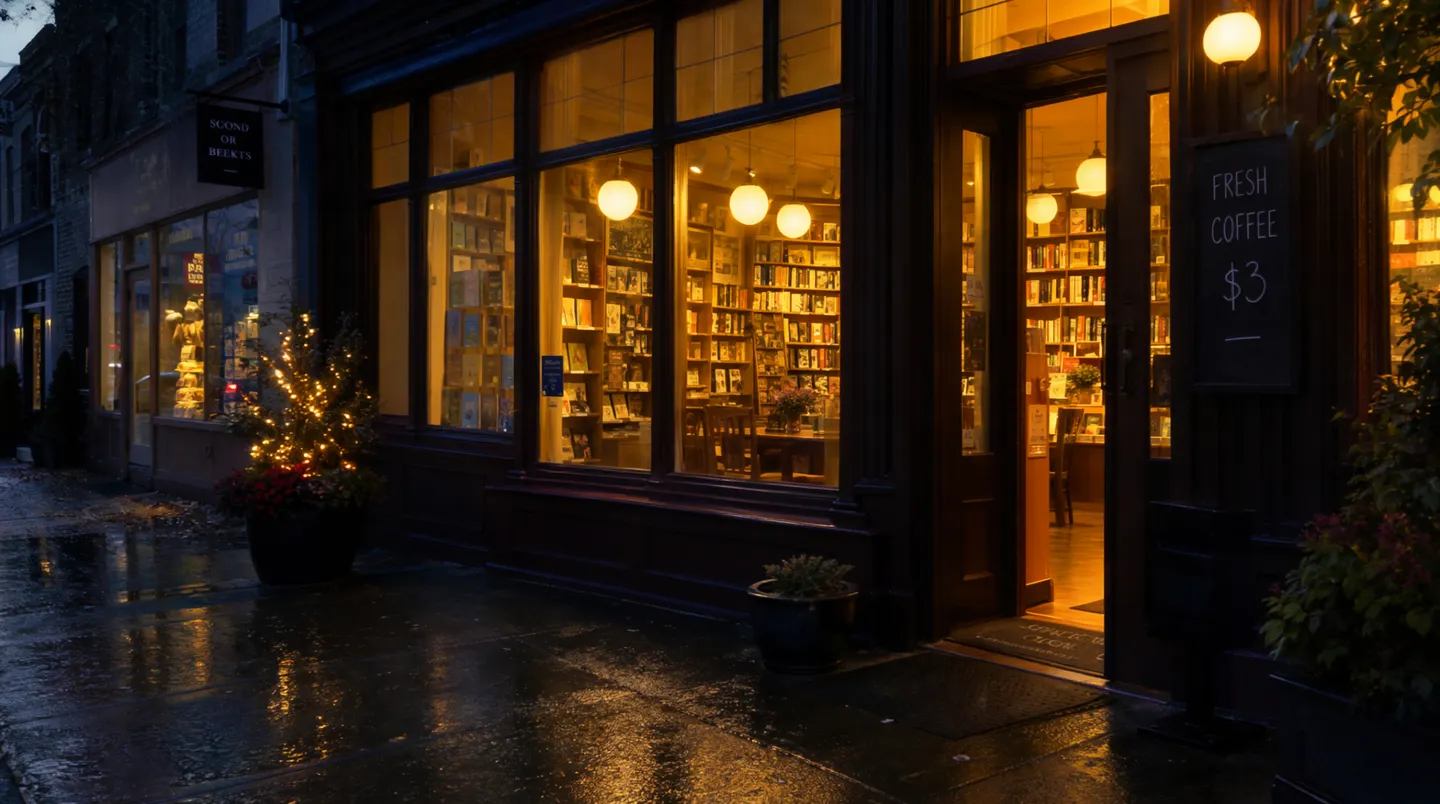
A cozy bookstore cafe at night seen from the rainy street, warm light spilling from tall windows onto wet cobblestones. By the door stands a chalkboard sign that reads "FRESH COFFEE $3" in white hand-lettered capitals. Inside, shelves of books and a few readers at small wooden tables. Photo, eye level, 35mm, soft reflections in the puddles, muted teal street against amber interior light.Waarom dit werkt: Eén alinea beschrijft de hele scène, de woorden op het bord staan exact tussen aanhalingstekens met hun uiterlijk, en camera, licht en palet worden benoemd. Een beeldverhouding van 3:2 past hier goed bij.
Handgeschreven Chinees, afgebroken waar jij wilt
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small yellow sticky note on the refrigerator door is handwritten in Chinese:
"记得买牛奶和鸡蛋!
牛奶两盒,鸡蛋一打。
顺便带一袋面包。"
Waarom dit werkt: De beschrijving is in het Engels en het briefje blijft in het Chinees, met een echte regeleinde waar een regel handschrift moet eindigen. Het briefje luidt: "Vergeet melk en eieren niet te kopen! Twee pakken melk, een dozijn eieren. Haal ook een brood mee."
Een gedetailleerd portret
An elderly lighthouse keeper in a heavy cable-knit wool sweater stands at the top of a spiral iron staircase, holding a brass oil lamp at chest height. Behind him, the great glass lens of the lighthouse glows gold; through the round, salt-stained windows, storm clouds and white-capped waves roll in at dusk. Weathered face, short gray beard, calm eyes looking just past the camera. 35mm film photograph, medium shot from slightly below, shallow depth of field. Warm lamplight on his face against the cold blue dusk outside. Muted palette of brass, navy, and slate.Waarom dit werkt: Elk onderdeel van het beeld krijgt zijn eigen feiten, en twee lichtbronnen met verschillende kleuren zetten de sfeer neer door contrast in plaats van met sfeerwoorden.
Anime-art met tags
best quality, highres, 1girl, solo, long blue hair, twin tails, futuristic stage outfit, holding a microphone, stage lights, cheering crowd in the background, dynamic angleWaarom dit werkt: MOSS-Image leest ook tags in animestijl: eerst kwaliteit, dan het personage, dan al het andere. Gebruik tags voor anime-art en zinnen voor al het andere.
Gevorderd
Gevorderd prompten voor MOSS-Image
Technieken voor meer controle zodra de basis zit.
Structuur: een beschrijving, tags of een layout
MOSS-Image begrijpt drie soorten prompts. Een beschrijving (caption), de standaard, is samenhangende tekst over alles wat je ziet: onderwerp en actie, uiterlijk, omgeving, camera en kadrering, medium, licht, materialen, palet en sfeer, waarbij je met woorden aangeeft waar dingen staan. Tags zijn door komma's gescheiden trefwoorden in animestijl. Een layout is een JSON-prompt die elk tekstblok en elk object in een eigen vak zet, zie hieronder.
Je kunt tekst en structuur combineren, en voor een gedetailleerde afbeelding heb je geen layout nodig. Gebruik er alleen een als de plaatsing exact moet zijn: een poster, een menu, meerdere panelen of objecten die op vaste plekken moeten staan.
- Houd vast aan wat je hebt gevraagd en vul alleen de gaten op: wil je een aquarel, voeg dan het licht, de kadrering en het palet van een aquarel toe, geen woorden die het richting een foto trekken.
- Schrijf tags in de volgorde waarin het model ze heeft geleerd: quality, score, meta, year, character, series, artist, daarna algemene tags zoals 1girl, blue hair of stage lights.
- Schrijf een artist-tag zonder de @ ervoor. Mage leest @ gevolgd door letters als een opgeslagen handle, en bij een handle die je niet hebt opgeslagen stopt de generatie voordat er iets wordt afgeschreven.
- Stapel geen kwaliteitstags op een beschrijving. "Masterpiece, 8k, ultra detailed" voegt niets toe wat een gewone beschrijving van het licht, de lens en de materialen niet beter doet.
Tekst in de afbeelding
Tekst is een van de sterkste punten van MOSS-Image, in het Engels en in het Chinees. Zet de woorden exact tussen aanhalingstekens, in hun eigen taal, met hoofdletters, leestekens en regeleinden, en houd ze gescheiden van wat je erover zegt: a sign that reads "OPEN", niet "write open on the sign in a fun way".
MOSS-Image verdeelt lange tekst zelf over regels, en niet altijd waar jij dat zou doen. Zet in de prompt een echte regeleinde waar een regel moet eindigen, zoals in het voorbeeld met het geeltje hierboven.
- Zeg hoe de tekst eruitziet en waar die staat: "in large looping chalk script across the top", "in small clean capitals along the bottom edge".
- Schrijf altijd de echte woorden, nooit een plaatshouder zoals "headline here": het model tekent alles wat tussen de aanhalingstekens staat.
- Gebruik een layoutprompt voor meerdere tekstblokken op vaste plekken, zoals een poster met een titel, een datum en een locatie.
Een krijtbordmenu met regels die jij bepaalt
A black chalkboard menu hanging on a white brick wall in a small cafe, hand-lettered in white and yellow chalk. At the top, the title "TODAY" in large looping script. Below it, three lines in neat capitals, one under the other:
"ESPRESSO 3.00
FLAT WHITE 4.50
CHAI LATTE 4.75"
A small chalk drawing of a steaming cup sits in the lower right corner. Photo, straight on, soft daylight from a window on the left.
Waarom dit werkt: De titel en de drie regels staan exact tussen aanhalingstekens en zijn afgebroken waar ze moeten breken, en de tekening heeft een eigen hoek, zodat de woorden er niet tegenaan drukken.
Layoutprompts: een vak voor elk element
Een layoutprompt is een experimentele JSON-prompt. De "summary" beschrijft de hele afbeelding en de stijl; de "items" noemen elk tekstblok en elk object met een beschrijving, de exacte woorden voor tekst en een vak. Plak hem als één regel in de prompt.
Vakken zijn pixelcoördinaten, gemeten vanuit het midden van de afbeelding en geschreven als boven, links, onder, rechts. Teken elk vak eerst op de gebruikelijke manier, van de linkerbovenhoek (x1, y1) naar de rechteronderhoek (x2, y2), op een afbeelding van W pixels breed en H pixels hoog. Trek daarna de halve hoogte af van elke y en de halve breedte van elke x, en schrijf ze in de volgorde y1, x1, y2, x2. Op een vierkant van 1024 bij 1024 wordt een titel van x 128 tot 896 en van y 96 tot 224 dus [-416, -384, -288, 384].
De vakken moeten passen bij de afbeelding die je genereert: de beeldverhouding 1:1 met een resolutie van 1K is 1024 bij 1024 pixels. Wil je een andere vorm, genereer dan eerst één afbeelding met die beeldverhouding en resolutie, controleer de breedte en hoogte en teken je vakken voor dat formaat.
- Bewaar de layout als bron: wil je de titel verplaatsen of een woord aanpassen, wijzig dan dat ene item en genereer opnieuw.
- Gebruik een tekstitem voor elk blok woorden, met de echte woorden in het veld "text", en een objectitem voor alles wat een plek nodig heeft.
- Zet Prompt Enhance uit en laat het Prompt Filter leeg: beide voegen woorden aan de prompt toe, en een layout moet precies zo aankomen als je hem hebt geschreven.
- Vakken die je voor één beeldverhouding of resolutie hebt getekend, komen bij een andere op de verkeerde plek terecht. Genereer op het formaat waarvoor je hebt getekend.
Een reisposter, vak voor vak geplaatst
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}Waarom dit werkt: De summary bepaalt de hele poster, de titel heeft zijn exacte woord en zijn vak bovenaan, en de berg heeft eronder een eigen vak. De vakken zijn getekend voor 1024 bij 1024, dus stel de beeldverhouding in op 1:1 en de resolutie op 1K.
Een personage hetzelfde houden
MOSS-Image accepteert geen uploads, Characters of References: alles komt uit de woorden. Wil je dat een persoon in een reeks hetzelfde blijft, schrijf dan één vaste beschrijving (leeftijd, postuur, gezicht, haar, kleding) en plak die woord voor woord in elke prompt, waarbij je alleen de zinnen over de scène aanpast. Zet ook de Seed vast.
Wil je aansluiten op een afbeelding die je al hebt, of op een opgeslagen Character, gebruik dan een model dat referenties accepteert, zoals Mango.
Stijl, licht en LoRA's
Benoem het medium precies: 35mm film photograph, editorial studio portrait, watercolor illustration, flat vector poster, anime key visual. Beschrijf het licht daarna aan de hand van bron en kleur ("warm lamplight on his face against the cold blue dusk outside") in plaats van met sfeerwoorden.
Voor een stijl die het basismodel niet heeft, voeg je onder Model een MOSS-Image-LoRA uit de community toe. Die begint met een sterkte van 0,5; verhoog hem richting 1 als de stijl nauwelijks zichtbaar is, en verlaag hem als de stijl het onderwerp overneemt.
- Staan er op de pagina van een LoRA triggerwoorden, zet die dan in de prompt.
- Materialen laten een beeld echt overkomen: salt-stained glass, worn brass, wet cobblestones, cable-knit wool.
Steps, Guidance Scale en de negatieve prompt
Steps en Guidance Scale staan standaard op het eigen recept van het model: 50 stappen met een guidance van 3. Dat is ook de beste plek voor ze. Minder stappen gaan sneller, maar verliezen detail. Verhoog Guidance Scale alleen naar 4 tot 6 als een korte prompt er te vaag uitkomt; een lange, gedetailleerde prompt heeft niet meer dan 3 nodig.
De negatieve prompt is standaard leeg. Blijft er iets terugkomen wat je niet wilt, begin dan met "worst quality, bad anatomy, watermark, jpeg artifact" en vul het aan. Bij een Guidance Scale van 1 doet de negatieve prompt niets, dus de app verbergt hem.
- Met dezelfde Seed en instellingen levert dezelfde prompt dezelfde afbeelding op. Pas steeds één zin aan om te zien wat elke zin doet.
Veelgemaakte fouten
Dit liever niet, doe dit in plaats daarvan
Vermijd: Een korte prompt.
coffee shop at night, rain, neon signBeter: Een volledige beschrijving: MOSS-Image is gemaakt voor lange prompts.
A small corner coffee shop at night seen from across a rainy street. A pink neon sign in the window reads "OPEN LATE" in looping script; inside, a barista wipes the counter under a row of hanging bulbs. Photo, eye level, 35mm, rain streaks catching the neon, deep blue street against warm pink and amber light.Vermijd: Kwaliteitstags achter een prompt in zinnen: "masterpiece, 8k, ultra detailed".
Beter: Een heldere beschrijving van het licht, de camera en de materialen.
Vermijd: Plaatshoudertekst: "a poster with a headline".
A concert poster with a headline and the date.Beter: De echte woorden tussen aanhalingstekens.
A concert poster with the headline "SUMMER NIGHTS" in tall white letters across the top and "AUGUST 14" in small capitals along the bottom.Vermijd: Regeleinden aan het model overlaten.
Beter: Een echte regeleinde in de prompt op elke plek waar een tekstregel moet eindigen.
Vermijd: Een @ voor een kunstenaarstag.
Beter: De naam van de kunstenaar zonder @, of de stijl in woorden beschreven.
Vermijd: Lay-outvakken getekend voor het ene formaat, maar gegenereerd in een ander.
Beter: De beeldverhouding en resolutie waarvoor de vakken getekend zijn.
Vermijd: Prompt Enhance aan.
Beter: Prompt Enhance uit: het voegt willekeurige woorden toe aan een prompt die je zorgvuldig hebt geschreven.
Veelgestelde vragen
Vragen over prompten voor MOSS-Image
Hoe lang moet een MOSS-Image-prompt zijn?
Kan MOSS-Image tekst maken?
Ondersteunt MOSS-Image negatieve prompts?
Hoe houd ik een personage consistent in MOSS-Image?
Wat is een MOSS-Image-lay-outprompt?
Moet ik MOSS-Image-prompts in het Chinees schrijven?
Moet ik Steps of Guidance Scale aanpassen?
Promptgids
Meer promptgidsen
Zo schrijf je prompts voor Anima
Zo schrijf je prompts voor Anima op Mage: Danbooru-tagvolgorde, ratingtags, sterke gewichten, geëscapete haakjes en Anima-promptvoorbeelden voor personages en scènes.
Zo schrijf je prompts voor Chroma
Chroma-promptgids: zo schrijf je een prompt voor Chroma met één alinea in bijschriftstijl, gebruik je de negatieve prompt, stel je steps en guidance af en kopieer je Chroma-promptvoorbeelden.
Zo schrijf je prompts voor Flux 2
Flux 2 promptgids: zo schrijf je prompts voor Flux 2 Dev met het onderwerp vooraan, JSON-prompts, exacte hex-kleuren en bewerkingen met meerdere afbeeldingen, met voorbeelden.
Zo schrijf je prompts voor GPT Image 2
Promptgids voor GPT Image 2: zo schrijf je prompts voor GPT Image 2.5 Flare en Sunburst voor exacte tekst, precieze bewerkingen en consistente personages, met voorbeelden.
Zo schrijf je prompts voor Grok Image
Grok Imagine-promptgids: zo schrijf je prompts voor Grok Image met de onderwerp-eerst-volgorde van xAI, een controleer-en-bewerk-lus en kopieerbare voorbeeldprompts voor foto's.
Zo schrijf je prompts voor Guava
Zo schrijf je prompts voor Guava, het fotorealistische model van Mage: een snelle start, een invulsjabloon en tips van experts voor portretten, huid, licht, lenzen, bewerkingen en tekst.

Maak je eerste afbeelding met MOSS-Image
Nieuwe accounts krijgen 300 gratis Gems, genoeg om MOSS-Image te proberen. Geen installatie, geen creditcard.
Probeer MOSS-Image