
Guide de prompts
Comment écrire un prompt pour MOSS-Image
Guide de prompts MOSS-Image : comment écrire tes prompts pour cette IA de génération d'images avec de longues descriptions, du texte exact en anglais et en chinois, des prompts de mise en page et des exemples à copier.
Démarrage rapide
Ton premier super prompt pour MOSS-Image
Tout ce dont un débutant a besoin en une minute : ce qu'il faut savoir d'abord, les règles les plus importantes, un modèle à remplir et des prompts à copier.
À savoir d'abord
MOSS-Image est conçu pour des prompts longs et détaillés : il lit un paragraphe entier et le suit de près, donc un prompt d'une seule ligne le gaspille. Décris l'image en phrases simples : le sujet et ce qu'il fait, le décor, la caméra, le médium, la lumière, les matières et les couleurs. Mets entre guillemets doubles les mots qui doivent apparaître dans l'image. Il crée des images à partir du texte seul, donc rien à importer, et la taille et le format sont des réglages.
Les règles les plus importantes
Décris tout
Sujet et action, décor, caméra et cadrage, médium, lumière, matières et palette. Tout ce que tu omets, MOSS-Image le décide à ta place : un paragraphe complet vaut mieux qu'une courte phrase.
Cite les mots exacts
Mets le texte entre guillemets doubles, exactement comme il doit apparaître, avec son emplacement et son style : un panneau à la craie près de la porte qui indique "FRESH COFFEE $3" en capitales blanches écrites à la main.
Écris le prompt en anglais
L'anglais donne les meilleurs résultats. Garde le texte à afficher dans sa propre langue entre les guillemets, comme une enseigne de magasin en chinois dans une description en anglais.
Utilise le prompt négatif pour ce qui revient sans cesse
Une courte liste comme "worst quality, bad anatomy, watermark, jpeg artifact" nettoie la plupart des images. Le prompt principal décrit uniquement ce que tu veux.
Laisse l'amélioration du prompt désactivée
Elle ajoute des mots au hasard à la fin de ton prompt. Un prompt MOSS-Image détaillé est meilleur tel que tu l'as écrit.
Remplis ce modèle
Remplace chaque partie entre crochets par ton idée, et supprime celles dont tu n'as pas besoin.
[Subject doing what] in [setting]. [Other details, each in its place]. [Any text, in double quotes, and where it appears]. [Medium], [camera and framing]. [Light and its source]. [Palette and mood].A street cook in a red apron tosses noodles in a smoking wok at a crowded night market stall. Steam rises past paper lanterns strung overhead; on the left, a line of customers waits under a striped awning. A hand-painted wooden sign above the stall reads "LATE NIGHT NOODLES" in bold yellow letters. Photo, eye level, 35mm, shallow depth of field. Warm light from the lanterns and a cold blue glow from the street behind. Amber and teal palette, busy and cheerful.[Subject doing what]Qui ou quoi est le sujet de l'image, avec l'action : un cuisinier de rue en tablier rouge fait sauter des nouilles dans un wok fumant.[setting]Où et quand : un stand bondé d'un marché de nuit.[Other details, each in its place]Tout le reste dans le cadre, placé avec des mots : à gauche, au-dessus, au premier plan.[Any text, in double quotes, and where it appears]Les mots exacts et leur apparence : une enseigne peinte à la main au-dessus du stand indique "LATE NIGHT NOODLES". Omets-le si tu ne veux pas de texte.[Medium]Le type d'image : photo, photographie argentique 35 mm, illustration à l'aquarelle, affiche vectorielle à plat.[camera and framing]D'où l'on regarde : à hauteur des yeux, un plan large, un gros plan en légère contre-plongée.[Light and its source]Ce qui éclaire la scène : la lumière chaude de lanternes en papier suspendues.[Palette and mood]Les couleurs principales et l'ambiance : ambre et bleu-vert, animé et joyeux.
Des prompts pour te lancer
Une enseigne dans une scène réaliste
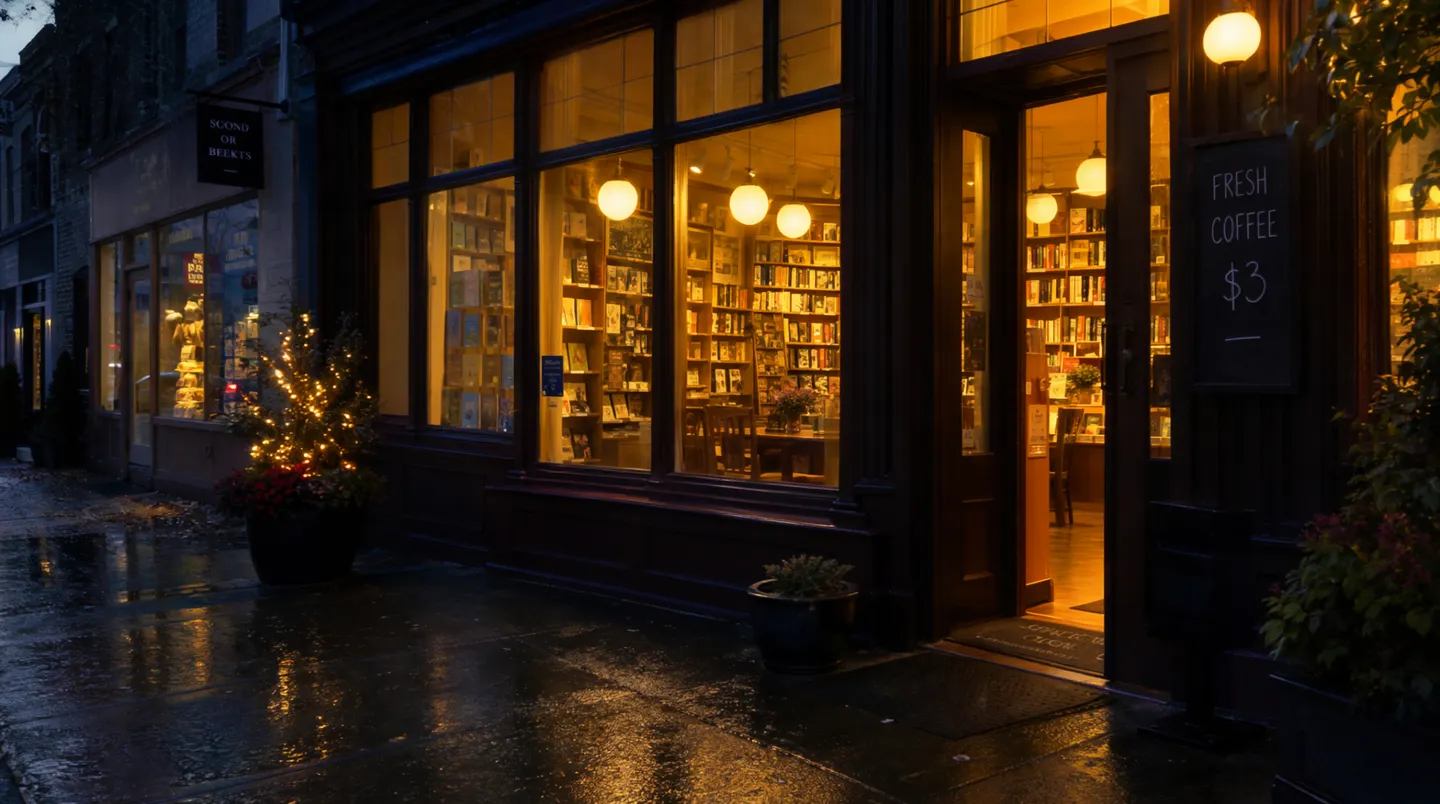
A cozy bookstore cafe at night seen from the rainy street, warm light spilling from tall windows onto wet cobblestones. By the door stands a chalkboard sign that reads "FRESH COFFEE $3" in white hand-lettered capitals. Inside, shelves of books and a few readers at small wooden tables. Photo, eye level, 35mm, soft reflections in the puddles, muted teal street against amber interior light.Pourquoi ça marche: Un seul paragraphe couvre toute la scène, les mots de l'enseigne sont cités exactement avec leur apparence, et la caméra, la lumière et la palette sont nommées. Un format 3:2 lui convient bien.
Du chinois manuscrit, avec les retours à la ligne où tu veux
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small yellow sticky note on the refrigerator door is handwritten in Chinese:
"记得买牛奶和鸡蛋!
牛奶两盒,鸡蛋一打。
顺便带一袋面包。"
Pourquoi ça marche: La description est en anglais et la note reste en chinois, avec un vrai retour à la ligne partout où une ligne d'écriture doit se terminer. La note dit : « N'oublie pas d'acheter du lait et des œufs ! Deux briques de lait, une douzaine d'œufs. Prends aussi un sac de pain. »
Un portrait détaillé
An elderly lighthouse keeper in a heavy cable-knit wool sweater stands at the top of a spiral iron staircase, holding a brass oil lamp at chest height. Behind him, the great glass lens of the lighthouse glows gold; through the round, salt-stained windows, storm clouds and white-capped waves roll in at dusk. Weathered face, short gray beard, calm eyes looking just past the camera. 35mm film photograph, medium shot from slightly below, shallow depth of field. Warm lamplight on his face against the cold blue dusk outside. Muted palette of brass, navy, and slate.Pourquoi ça marche: Chaque partie de l'image a ses propres précisions, et deux lumières de couleurs différentes créent l'ambiance par contraste plutôt qu'avec des mots d'ambiance.
De l'art animé à partir de tags
best quality, highres, 1girl, solo, long blue hair, twin tails, futuristic stage outfit, holding a microphone, stage lights, cheering crowd in the background, dynamic anglePourquoi ça marche: MOSS-Image comprend aussi les tags de style anime : d'abord la qualité, puis le personnage, puis tout le reste. Utilise des tags pour l'art animé et des phrases pour tout le reste.
Avancé
Prompts avancés pour MOSS-Image
Des techniques pour mieux contrôler le résultat une fois les bases acquises.
Structure : une description, des tags ou une mise en page
MOSS-Image comprend trois types de prompt. La description, par défaut, est un texte rédigé et cohérent sur tout ce qui se voit : sujet et action, apparence, décor, caméra et cadrage, médium, lumière, matières, palette et ambiance, avec la position des éléments dite avec des mots. Les tags sont des mots-clés de style anime séparés par des virgules. Une mise en page est un prompt JSON qui place chaque bloc de texte et chaque objet dans sa propre boîte, expliqué plus bas.
Le texte rédigé et la structure peuvent se combiner, et une image détaillée n'a pas besoin de mise en page. N'en utilise une que lorsque le placement doit être exact : une affiche, un menu, plusieurs cases, ou des objets qui doivent se trouver à des endroits précis.
- Garde ce que tu as demandé et comble seulement les manques : si tu veux une aquarelle, ajoute la lumière, le cadrage et la palette d'une aquarelle, pas des mots qui tirent vers la photo.
- Écris les tags dans l'ordre où le modèle les a appris : qualité, score, méta, année, personnage, série, artiste, puis les tags généraux comme 1girl, blue hair ou stage lights.
- Écris un tag d'artiste sans le @ devant. Mage lit @ suivi de lettres comme un identifiant enregistré, et un identifiant que tu n'as pas enregistré arrête la génération avant tout débit.
- N'empile pas de tags de qualité sur une description. "Masterpiece, 8k, ultra detailed" n'apporte rien de plus qu'une description simple de la lumière, de l'objectif et des matières, qui fait mieux.
Texte dans l'image
Le texte est l'un des grands points forts de MOSS-Image, en anglais comme en chinois. Cite les mots exactement, dans leur propre langue, en gardant leurs majuscules, leur ponctuation et leurs retours à la ligne, et sépare-les de ce que tu en dis : une enseigne qui indique "OPEN", et non "écris open sur l'enseigne de façon amusante".
MOSS-Image découpe lui-même les longs textes en lignes, et pas toujours là où tu le voudrais. Mets un vrai retour à la ligne dans le prompt partout où une ligne doit se terminer, comme dans l'exemple du post-it plus haut.
- Dis à quoi ressemble le texte et où il se trouve : "en grande écriture cursive à la craie en haut", "en petites capitales nettes le long du bord inférieur".
- Écris toujours les vrais mots, jamais un texte provisoire comme "titre ici" : le modèle dessine tout ce qui est entre guillemets.
- Pour plusieurs blocs de texte à des endroits fixes, comme une affiche avec un titre, une date et un lieu, utilise un prompt de mise en page.
Un menu à la craie avec des lignes que tu contrôles
A black chalkboard menu hanging on a white brick wall in a small cafe, hand-lettered in white and yellow chalk. At the top, the title "TODAY" in large looping script. Below it, three lines in neat capitals, one under the other:
"ESPRESSO 3.00
FLAT WHITE 4.50
CHAI LATTE 4.75"
A small chalk drawing of a steaming cup sits in the lower right corner. Photo, straight on, soft daylight from a window on the left.
Pourquoi ça marche: Le titre et les trois lignes sont cités exactement et coupés là où ils doivent l'être, et le dessin a son propre coin, pour que les mots ne l'encombrent pas.
Prompts de mise en page : une boîte pour chaque élément
Un prompt de mise en page est un prompt JSON expérimental. Son "summary" décrit l'image entière et son style ; ses "items" listent chaque bloc de texte et chaque objet avec une description, les mots exacts pour le texte, et une boîte. Colle-le dans le prompt sur une seule ligne.
Les boîtes sont des coordonnées en pixels mesurées depuis le centre de l'image, écrites dans l'ordre haut, gauche, bas, droite. Dessine d'abord chaque boîte de la façon habituelle, de son coin supérieur gauche (x1, y1) à son coin inférieur droit (x2, y2), sur une image de W pixels de large et H pixels de haut. Ensuite, soustrais la moitié de la hauteur à chaque y et la moitié de la largeur à chaque x, puis écris-les dans l'ordre y1, x1, y2, x2. Sur un carré de 1024 par 1024, un titre allant de x 128 à 896 et de y 96 à 224 devient [-416, -384, -288, 384].
Les boîtes doivent correspondre à l'image que tu génères : le format 1:1 en résolution 1K fait 1024 par 1024 pixels. Pour une autre forme, génère d'abord une image avec ce format et cette résolution, vérifie sa largeur et sa hauteur, puis dessine tes boîtes pour cette taille.
- Garde la mise en page comme source : pour déplacer le titre ou changer un mot, modifie cet élément et génère à nouveau.
- Utilise un élément de texte pour chaque bloc de mots, avec les vrais mots dans son champ "text", et un élément d'objet pour chaque chose qui a besoin d'une place.
- Désactive l'amélioration du prompt et laisse le filtre de prompt vide : tous deux ajoutent des mots au prompt, et une mise en page doit arriver exactement telle qu'elle est écrite.
- Des boîtes dessinées pour un format ou une résolution se retrouvent au mauvais endroit avec un autre. Génère à la taille pour laquelle tu as dessiné.
Une affiche de voyage, placée boîte par boîte
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}Pourquoi ça marche: Le résumé définit toute l'affiche, le titre a son mot exact et sa boîte en haut, et la montagne a sa propre boîte en dessous. Les boîtes sont dessinées pour 1024 par 1024, donc règle le format sur 1:1 et la résolution sur 1K.
Garder un personnage identique
MOSS-Image n'accepte ni imports, ni Characters, ni References : tout vient des mots. Pour garder la même personne dans toute une série, écris une description fixe d'elle (âge, silhouette, visage, cheveux, vêtements) et colle-la mot pour mot dans chaque prompt, en ne changeant que les phrases sur la scène. Fixe aussi la Seed.
Pour reproduire une image que tu as déjà, ou un Character enregistré, utilise un modèle qui accepte les références, comme Mango.
Style, lumière et LoRA
Nomme précisément le médium : photographie argentique 35 mm, portrait de studio éditorial, illustration à l'aquarelle, affiche vectorielle à plat, key visual d'anime. Puis décris la lumière par sa source et sa couleur ("la lumière chaude d'une lampe sur son visage face au bleu froid du crépuscule dehors") plutôt qu'avec des mots d'ambiance.
Pour un style que le modèle de base n'a pas, ajoute un LoRA MOSS-Image de la communauté dans Modèle. Il démarre à une intensité de 0,5 ; augmente-la vers 1 si le style se voit à peine, et baisse-la s'il prend le dessus sur le sujet.
- Si la page d'un LoRA liste des mots déclencheurs, mets-les dans le prompt.
- Les matières donnent un aspect réel à une image : verre marqué par le sel, laiton usé, pavés mouillés, laine torsadée.
Étapes, échelle de guidage et prompt négatif
Les Étapes et l'Échelle de guidage démarrent sur la recette du modèle, 50 étapes avec un guidage de 3, et c'est le meilleur réglage. Moins d'étapes, c'est plus rapide, mais tu perds en détails. Monte l'Échelle de guidage vers 4 à 6 seulement quand un prompt court donne un résultat flou ; un prompt long et détaillé n'a pas besoin de plus de 3.
Le prompt négatif est vide par défaut. Quand un élément indésirable revient sans cesse, commence par « worst quality, bad anatomy, watermark, jpeg artifact » et complète. Avec une Échelle de guidage de 1, le prompt négatif ne sert à rien, donc l'app le masque.
- Avec le même Seed et les mêmes réglages, un même prompt donne la même image. Modifie une phrase à la fois pour voir ce que chacune change.
Erreurs courantes
À éviter, et quoi faire à la place
À éviter: Un prompt court.
coffee shop at night, rain, neon signÀ la place: Une description complète : MOSS-Image est conçu pour les longues.
A small corner coffee shop at night seen from across a rainy street. A pink neon sign in the window reads "OPEN LATE" in looping script; inside, a barista wipes the counter under a row of hanging bulbs. Photo, eye level, 35mm, rain streaks catching the neon, deep blue street against warm pink and amber light.À éviter: Des tags de qualité empilés sur un prompt en phrases : « masterpiece, 8k, ultra detailed ».
À la place: Une description simple de la lumière, de la caméra et des matières.
À éviter: Un texte bouche-trou : « une affiche avec un titre ».
A concert poster with a headline and the date.À la place: Les vrais mots, entre guillemets.
A concert poster with the headline "SUMMER NIGHTS" in tall white letters across the top and "AUGUST 14" in small capitals along the bottom.À éviter: Les retours à la ligne laissés au modèle.
À la place: Un vrai retour à la ligne dans le prompt à chaque fin de ligne de texte.
À éviter: Un @ devant un tag d'artiste.
À la place: Le nom de l'artiste sans le @, ou le style décrit avec des mots.
À éviter: Des zones de mise en page dessinées pour une taille, mais générées dans une autre.
À la place: Le format et la résolution pour lesquels les zones ont été dessinées.
À éviter: Prompt Enhance activé.
À la place: Amélioration du prompt désactivée : elle ajoute des mots au hasard à un prompt que tu as écrit avec soin.
FAQ
Questions sur les prompts pour MOSS-Image
Quelle longueur pour un prompt MOSS-Image ?
MOSS-Image sait-il écrire du texte ?
MOSS-Image accepte-t-il les prompts négatifs ?
Comment garder un personnage cohérent dans MOSS-Image ?
Qu'est-ce qu'un prompt de mise en page MOSS-Image ?
Dois-je écrire mes prompts MOSS-Image en chinois ?
Dois-je modifier les Étapes ou l'Échelle de guidage ?
Guide de prompts
D'autres guides de prompts
Comment écrire un prompt pour Anima
Comment écrire tes prompts pour Anima sur Mage : ordre des tags Danbooru, tags de rating, poids forts, parenthèses échappées, et exemples de prompts Anima pour des personnages et des décors.
Comment écrire un prompt pour Chroma
Guide de prompts Chroma : comment écrire un prompt Chroma en un seul paragraphe façon légende, utiliser son prompt négatif, régler les étapes et la guidance, et copier des exemples de prompts Chroma.
Comment écrire un prompt pour Flux 2
Guide de prompts Flux 2 : comment écrire un prompt pour Flux 2 Dev avec le sujet en premier, des prompts JSON, des couleurs hex exactes et des retouches multi-images, avec des exemples.
Comment écrire un prompt pour GPT Image 2
Guide de prompts GPT Image 2 : comment écrire tes prompts pour GPT Image 2.5 Flare et Sunburst afin d'obtenir du texte exact, des retouches précises et des personnages cohérents, avec des exemples.
Comment écrire un prompt pour Grok Image
Guide de prompts Grok Imagine : comment écrire des prompts pour Grok Image avec l'ordre sujet d'abord de xAI, une boucle vérifier puis retoucher et des exemples de prompts photo à copier.
Comment écrire un prompt pour Guava
Comment écrire des prompts pour Guava, le modèle photoréaliste de Mage : démarrage rapide, modèle à compléter et conseils d'expert pour les portraits, la peau, la lumière, les objectifs, les retouches et le texte.

Crée ta première image avec MOSS-Image
Les nouveaux comptes reçoivent 300 Gems gratuits, de quoi essayer MOSS-Image. Sans installation, sans carte bancaire.
Essayer MOSS-Image