
Guía de prompts
Cómo escribir prompts para MOSS-Image
Guía de prompts de MOSS-Image, el generador de imágenes con IA: cómo escribir prompts con descripciones largas, texto exacto en inglés y chino, prompts de diseño y ejemplos para copiar.
Inicio rápido
Tu primer gran prompt para MOSS-Image
Todo lo que un principiante necesita en un minuto: qué debes saber primero, las reglas más importantes, una plantilla para rellenar y prompts para copiar.
Qué debes saber primero
MOSS-Image está pensado para prompts largos y detallados: lee un párrafo entero y lo sigue al pie de la letra, así que un prompt de una sola línea lo desaprovecha. Describe la imagen con frases sencillas: el sujeto y lo que hace, el entorno, la cámara, el medio, la luz, los materiales y los colores. Pon entre comillas dobles las palabras que deban aparecer en la imagen. Solo crea imágenes a partir de texto, así que no hay nada que subir, y el tamaño y la forma son ajustes.
Las reglas más importantes
Describe todo
Sujeto y acción, entorno, cámara y encuadre, medio, luz, materiales y paleta. Lo que no incluyas, lo decide MOSS-Image por ti, así que un párrafo completo funciona mejor que una frase corta.
Pon las palabras exactas entre comillas
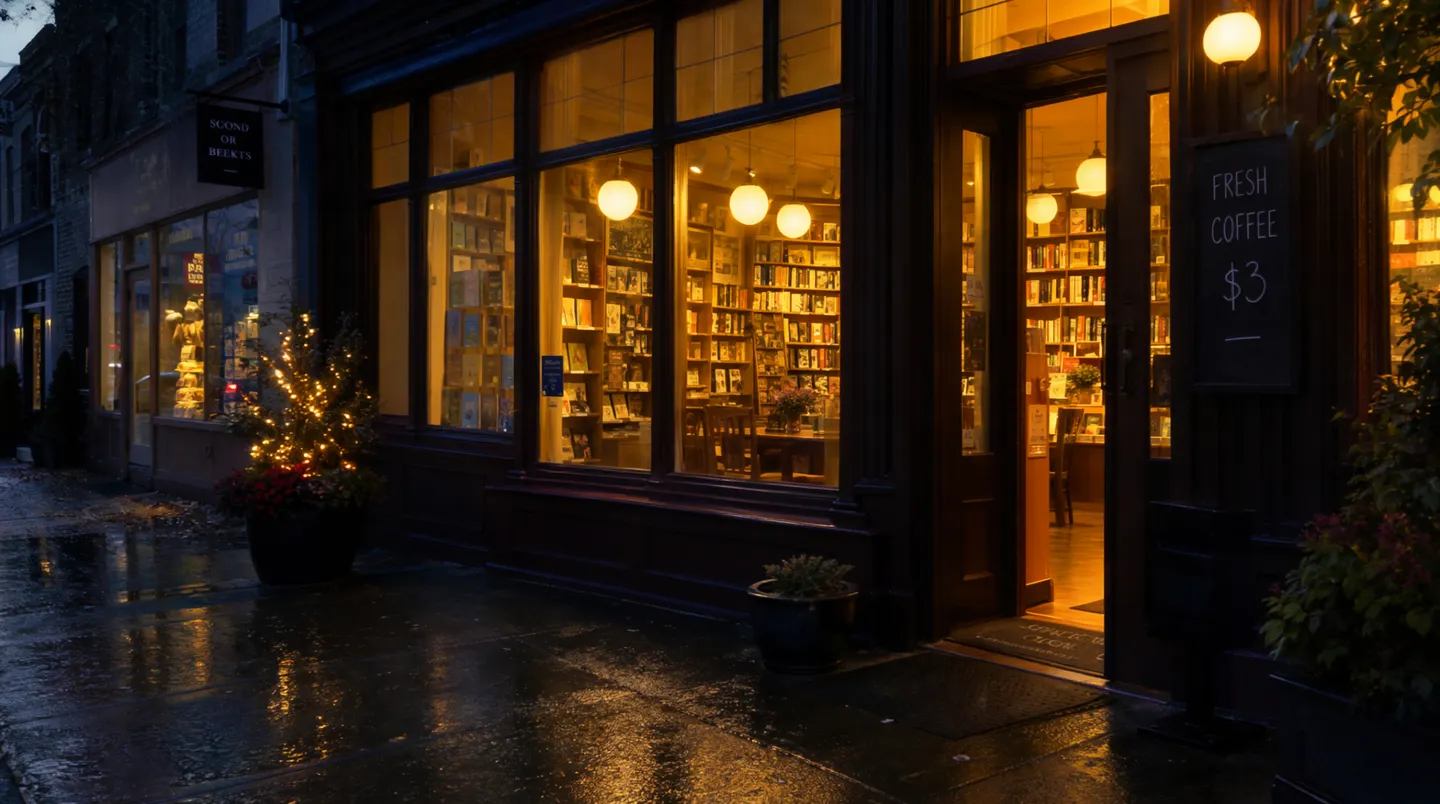
Pon el texto entre comillas dobles, tal como debe leerse, con su lugar y su aspecto: a chalkboard sign by the door that reads "FRESH COFFEE $3" in white hand-lettered capitals.
Escribe el prompt en inglés
El inglés da los mejores resultados. Deja el texto que quieres que aparezca en su propio idioma dentro de las comillas, por ejemplo un letrero de tienda en chino dentro de una descripción en inglés.
Usa el prompt negativo para lo que no deja de aparecer
Una lista corta como "worst quality, bad anatomy, watermark, jpeg artifact" limpia la mayoría de las imágenes. El prompt principal describe solo lo que quieres.
Deja Prompt Enhance desactivado
Añade palabras al azar al final de tu prompt. Un prompt detallado para MOSS-Image funciona mejor tal como lo escribiste.
Rellena esta plantilla
Sustituye cada parte entre corchetes por tu propia idea y omite las que no necesites.
[Subject doing what] in [setting]. [Other details, each in its place]. [Any text, in double quotes, and where it appears]. [Medium], [camera and framing]. [Light and its source]. [Palette and mood].A street cook in a red apron tosses noodles in a smoking wok at a crowded night market stall. Steam rises past paper lanterns strung overhead; on the left, a line of customers waits under a striped awning. A hand-painted wooden sign above the stall reads "LATE NIGHT NOODLES" in bold yellow letters. Photo, eye level, 35mm, shallow depth of field. Warm light from the lanterns and a cold blue glow from the street behind. Amber and teal palette, busy and cheerful.[Subject doing what]De quién o de qué trata la imagen, con la acción: a street cook in a red apron tosses noodles in a smoking wok.[setting]Dónde y cuándo: a crowded night market stall.[Other details, each in its place]Todo lo demás que aparece en el encuadre, ubicado con palabras: on the left, overhead, in the foreground.[Any text, in double quotes, and where it appears]Las palabras exactas y cómo se ven: a hand-painted sign above the stall reads "LATE NIGHT NOODLES". Omítelo si no quieres texto.[Medium]Qué tipo de imagen es: photo, 35mm film photograph, watercolor illustration, flat vector poster.[camera and framing]Desde dónde miramos: eye level, a wide shot, a close-up from slightly below.[Light and its source]Qué ilumina la escena: warm light from paper lanterns overhead.[Palette and mood]Los colores principales y la sensación: amber and teal, busy and cheerful.
Prompts para empezar
Un letrero en una escena real
A cozy bookstore cafe at night seen from the rainy street, warm light spilling from tall windows onto wet cobblestones. By the door stands a chalkboard sign that reads "FRESH COFFEE $3" in white hand-lettered capitals. Inside, shelves of books and a few readers at small wooden tables. Photo, eye level, 35mm, soft reflections in the puddles, muted teal street against amber interior light.Por qué funciona: Un párrafo cubre toda la escena, las palabras del letrero van entre comillas, exactas y con su aspecto, y se nombran la cámara, la luz y la paleta. Le va bien una relación de aspecto 3:2.
Chino escrito a mano, con los saltos donde tú quieras
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small yellow sticky note on the refrigerator door is handwritten in Chinese:
"记得买牛奶和鸡蛋!
牛奶两盒,鸡蛋一打。
顺便带一袋面包。"
Por qué funciona: La descripción está en inglés y la nota queda en chino, con un salto de línea real donde debe terminar cada renglón de la letra manuscrita. La nota dice: "¡Acuérdate de comprar leche y huevos! Dos cartones de leche, una docena de huevos. Trae también una bolsa de pan."
Un retrato detallado
An elderly lighthouse keeper in a heavy cable-knit wool sweater stands at the top of a spiral iron staircase, holding a brass oil lamp at chest height. Behind him, the great glass lens of the lighthouse glows gold; through the round, salt-stained windows, storm clouds and white-capped waves roll in at dusk. Weathered face, short gray beard, calm eyes looking just past the camera. 35mm film photograph, medium shot from slightly below, shallow depth of field. Warm lamplight on his face against the cold blue dusk outside. Muted palette of brass, navy, and slate.Por qué funciona: Cada parte de la imagen recibe sus propios datos, y dos luces de colores distintos crean el ambiente por contraste, en lugar de usar palabras de estado de ánimo.
Arte anime a partir de etiquetas
best quality, highres, 1girl, solo, long blue hair, twin tails, futuristic stage outfit, holding a microphone, stage lights, cheering crowd in the background, dynamic anglePor qué funciona: MOSS-Image también lee etiquetas de estilo anime: primero la calidad, luego el personaje y después todo lo demás. Usa etiquetas para el arte anime y frases para todo lo demás.
Avanzado
Prompts avanzados para MOSS-Image
Técnicas para tener más control cuando ya domines lo básico.
Estructura: una descripción, etiquetas o un diseño
MOSS-Image lee tres tipos de prompt. Una descripción, la opción por defecto, es prosa cohesionada sobre todo lo que se ve: sujeto y acción, aspecto, entorno, cámara y encuadre, medio, luz, materiales, paleta y ambiente, indicando con palabras dónde está cada cosa. Las etiquetas son palabras clave de estilo anime separadas por comas. Un diseño es un prompt en JSON que coloca cada bloque de texto y cada objeto en su propio recuadro, como se explica más abajo.
Se puede combinar prosa y estructura, y una imagen detallada no necesita un diseño. Recurre a él solo cuando la posición deba ser exacta: un póster, un menú, varios paneles u objetos que tengan que estar en lugares concretos.
- Conserva lo que pediste y rellena solo los huecos: si quieres una acuarela, añade la luz, el encuadre y la paleta de una acuarela, no palabras que la acerquen a una foto.
- Escribe las etiquetas en el orden en que el modelo las aprendió: quality, score, meta, year, character, series, artist y después las etiquetas generales como 1girl, blue hair o stage lights.
- Escribe la etiqueta de artista sin la @ delante. Mage interpreta @ seguida de letras como un handle guardado, y si el handle no está guardado, la generación se detiene antes de cobrar nada.
- No acumules etiquetas de calidad en una descripción. "Masterpiece, 8k, ultra detailed" no aporta nada que una descripción sencilla de la luz, el objetivo y los materiales no haga mejor.
Texto en la imagen
El texto es uno de los puntos fuertes de MOSS-Image, tanto en inglés como en chino. Pon las palabras entre comillas, exactas y en su propio idioma, con sus mayúsculas, su puntuación y sus saltos de línea, y sepáralas de lo que dices sobre ellas: a sign that reads "OPEN", no "write open on the sign in a fun way".
MOSS-Image divide los textos largos en líneas por su cuenta, y no siempre donde tú quisieras. Pon un salto de línea real en el prompt donde deba terminar cada línea, como en el ejemplo de la nota adhesiva de arriba.
- Indica cómo se ve el texto y dónde va: "in large looping chalk script across the top", "in small clean capitals along the bottom edge".
- Escribe siempre las palabras reales, nunca un marcador como "titular aquí": el modelo dibuja lo que haya entre las comillas.
- Para varios bloques de texto en posiciones fijas, como un póster con título, fecha y lugar, usa un prompt de diseño.
Un menú de pizarra con las líneas bajo tu control
A black chalkboard menu hanging on a white brick wall in a small cafe, hand-lettered in white and yellow chalk. At the top, the title "TODAY" in large looping script. Below it, three lines in neat capitals, one under the other:
"ESPRESSO 3.00
FLAT WHITE 4.50
CHAI LATTE 4.75"
A small chalk drawing of a steaming cup sits in the lower right corner. Photo, straight on, soft daylight from a window on the left.
Por qué funciona: El título y las tres líneas van entre comillas, exactos y con los saltos donde deben ir, y el dibujo tiene su propia esquina, así que las palabras no lo agobian.
Prompts de diseño: un recuadro para cada elemento
Un prompt de diseño es un prompt experimental en JSON. Su "summary" describe toda la imagen y su estilo; su lista "items" recoge cada bloque de texto y cada objeto con una descripción, las palabras exactas si es texto, y un recuadro. Pégalo en el prompt en una sola línea.
Los recuadros son coordenadas en píxeles medidas desde el centro de la imagen y escritas como arriba, izquierda, abajo, derecha. Primero dibuja cada recuadro de la forma habitual, desde su esquina superior izquierda (x1, y1) hasta su esquina inferior derecha (x2, y2), en una imagen de W píxeles de ancho y H de alto. Después resta la mitad de la altura a cada y y la mitad del ancho a cada x, y escríbelos en el orden y1, x1, y2, x2. En un cuadrado de 1024 por 1024, un título de x 128 a 896 y de y 96 a 224 queda como [-416, -384, -288, 384].
Los recuadros deben coincidir con la imagen que generes: la relación de aspecto 1:1 con resolución 1K es de 1024 por 1024 píxeles. Para otra forma, genera primero una imagen con esa relación de aspecto y resolución, comprueba su ancho y su alto, y dibuja tus recuadros para ese tamaño.
- Conserva el diseño como tu fuente: para mover el título o cambiar una palabra, edita ese elemento y vuelve a generar.
- Usa un elemento de texto para cada bloque de palabras, con las palabras reales en su campo "text", y un elemento de objeto para cada cosa que necesite un lugar.
- Desactiva Prompt Enhance y deja Prompt Filter vacío: ambos añaden palabras al prompt, y un diseño debe llegar exactamente como lo escribiste.
- Los recuadros dibujados para una relación de aspecto o resolución acaban en lugares equivocados con otra. Genera con el tamaño para el que los dibujaste.
Un póster de viajes, colocado recuadro a recuadro
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}Por qué funciona: El resumen define todo el póster, el título tiene su palabra exacta y su recuadro arriba, y la montaña tiene su propio recuadro debajo. Los recuadros están dibujados para 1024 por 1024, así que ajusta la relación de aspecto a 1:1 y la resolución a 1K.
Cómo mantener igual a un personaje
MOSS-Image no admite subidas, Characters ni References: todo sale de las palabras. Para mantener a una persona igual en una serie, escribe una descripción fija (edad, complexión, rostro, pelo, ropa) y pégala palabra por palabra en cada prompt, cambiando solo las frases sobre la escena. Fija también la Seed.
Para parecerte a una imagen que ya tienes, o a un Character guardado, usa un modelo que admita referencias, como Mango.
Estilo, luz y LoRAs
Nombra el medio con precisión: 35mm film photograph, editorial studio portrait, watercolor illustration, flat vector poster, anime key visual. Luego describe la luz por su fuente y su color ("warm lamplight on his face against the cold blue dusk outside") en lugar de usar palabras de ambiente.
Para un estilo que el modelo base no tiene, añade un LoRA de MOSS-Image de la comunidad en Modelo. Empieza con una intensidad de 0.5; súbela hacia 1 si el estilo apenas se nota, y bájala si el estilo se come al sujeto.
- Si la página de un LoRA indica palabras de activación, ponlas en el prompt.
- Los materiales hacen que una imagen parezca real: salt-stained glass, worn brass, wet cobblestones, cable-knit wool.
Steps, Guidance Scale y el prompt negativo
Steps y Guidance Scale empiezan con la receta propia del modelo, 50 pasos con una guía de 3, y es el mejor punto de partida. Con menos pasos va más rápido, pero se pierde detalle. Sube Guidance Scale hacia 4 o 6 solo cuando un prompt corto salga desdibujado; un prompt largo y detallado no necesita más de 3.
El prompt negativo está vacío por defecto. Si sigue apareciendo algo que no quieres, empieza con "worst quality, bad anatomy, watermark, jpeg artifact" y ve añadiendo más. Con un Guidance Scale de 1 el prompt negativo no hace nada, así que la app lo oculta.
- Con la misma Seed y los mismos ajustes, el mismo prompt genera la misma imagen. Cambia una frase cada vez para ver qué hace cada una.
Errores comunes
Evita esto, haz esto en su lugar
Evita: Un prompt corto.
coffee shop at night, rain, neon signEn su lugar: Una descripción completa: MOSS-Image está pensado para las largas.
A small corner coffee shop at night seen from across a rainy street. A pink neon sign in the window reads "OPEN LATE" in looping script; inside, a barista wipes the counter under a row of hanging bulbs. Photo, eye level, 35mm, rain streaks catching the neon, deep blue street against warm pink and amber light.Evita: Etiquetas de calidad apiladas sobre un prompt en forma de frase: "masterpiece, 8k, ultra detailed".
En su lugar: Una descripción sencilla de la luz, la cámara y los materiales.
Evita: Texto de relleno: "a poster with a headline".
A concert poster with a headline and the date.En su lugar: Las palabras reales entre comillas.
A concert poster with the headline "SUMMER NIGHTS" in tall white letters across the top and "AUGUST 14" in small capitals along the bottom.Evita: Saltos de línea que se dejan a criterio del modelo.
En su lugar: Un salto de línea real en el prompt allí donde deba terminar una línea de texto.
Evita: Una @ delante de la etiqueta de un artista.
En su lugar: El nombre del artista sin la @, o el estilo descrito con palabras.
Evita: Cuadros de composición dibujados para un tamaño y generados en otro.
En su lugar: La relación de aspecto y la resolución para las que se dibujaron los cuadros.
Evita: Prompt Enhance activado.
En su lugar: Prompt Enhance desactivado: añade palabras al azar a un prompt que escribiste con cuidado.
Preguntas frecuentes
Preguntas sobre prompts para MOSS-Image
¿Qué extensión debe tener un prompt de MOSS-Image?
¿MOSS-Image puede generar texto?
¿MOSS-Image admite prompts negativos?
¿Cómo mantengo un personaje coherente en MOSS-Image?
¿Qué es un prompt de composición de MOSS-Image?
¿Debo escribir los prompts de MOSS-Image en chino?
¿Debo cambiar Steps o Guidance Scale?
Guía de prompts
Más guías de prompts
Cómo escribir prompts para Anima
Cómo escribir prompts para Anima en Mage: orden de etiquetas Danbooru, etiquetas de clasificación, pesos fuertes, paréntesis escapados y ejemplos de prompts de Anima para personajes y escenas con IA.
Cómo escribir prompts para Chroma
Guía de prompts de Chroma: cómo escribir prompts para Chroma con un solo párrafo al estilo de un pie de foto, usar su prompt negativo, ajustar los pasos y la guía, y copiar ejemplos de prompts de Chroma.
Cómo escribir prompts para Flux 2
Guía de prompts de Flux 2: cómo escribir prompts para Flux 2 Dev con el sujeto al principio, prompts en JSON, colores hex exactos y ediciones con varias imágenes, con ejemplos.
Cómo escribir prompts para GPT Image 2
Guía de prompts de GPT Image 2: cómo escribir prompts para GPT Image 2.5 Flare y Sunburst y lograr texto exacto, ediciones precisas y personajes consistentes, con ejemplos.
Cómo escribir prompts para Grok Image
Guía de prompts de Grok Imagine: cómo escribir prompts para Grok Image con el orden de xAI que empieza por el sujeto, un ciclo de revisar y editar, y ejemplos de prompts de fotos para copiar.
Cómo escribir prompts para Guava
Cómo escribir prompts para Guava, el modelo de fotorrealismo de Mage: inicio rápido, plantilla para rellenar y consejos expertos para retratos, piel, luz, objetivos, ediciones y texto.

Crea tu primera imagen con MOSS-Image
Las cuentas nuevas reciben 300 Gems gratis, suficientes para probar MOSS-Image. Sin instalar nada y sin tarjeta de crédito.
Prueba MOSS-Image