
Poradnik promptów
Jak pisać prompty do MOSS-Image
Poradnik promptów do MOSS-Image, modelu AI do generowania obrazów: jak pisać długie opisy, dokładny tekst po angielsku i chińsku, prompty układu oraz przykłady do skopiowania.
Szybki start
Twój pierwszy świetny prompt do MOSS-Image
Wszystko, czego potrzebuje początkujący, w jedną minutę: co warto wiedzieć na start, najważniejsze zasady, szablon do uzupełnienia i prompty do skopiowania.
Co warto wiedzieć na start
MOSS-Image jest stworzony do długich, szczegółowych promptów: czyta cały akapit i trzyma się go bardzo dokładnie, więc prompt w jednej linijce to marnowanie jego możliwości. Opisz obraz zwykłymi zdaniami: kto lub co jest na nim i co robi, miejsce akcji, kamerę, medium, światło, materiały i kolory. Słowa, które mają pojawić się na obrazie, wpisz w cudzysłowie. Model tworzy obrazy wyłącznie z tekstu, więc nie ma tu nic do przesyłania, a rozmiar i proporcje to ustawienia.
Najważniejsze zasady
Opisz wszystko
Postać i akcja, miejsce, kamera i kadr, medium, światło, materiały i paleta barw. Czego nie opiszesz, o tym zdecyduje MOSS-Image, więc pełny akapit sprawdza się lepiej niż krótkie hasło.
Cytuj dokładne słowa
Tekst wpisz w cudzysłowie, dokładnie tak, jak ma brzmieć, razem z miejscem i wyglądem: tablica kredowa przy drzwiach z napisem „FRESH COFFEE $3” białymi, ręcznie pisanymi wersalikami.
Pisz prompt po angielsku
Po angielsku wyniki są najlepsze. Tekst, który ma znaleźć się na obrazie, zostaw w cudzysłowie w jego własnym języku, np. chiński szyld sklepu w angielskim opisie.
Użyj negatywnego promptu na to, co wciąż się pojawia
Krótka lista, na przykład „worst quality, bad anatomy, watermark, jpeg artifact”, poprawia większość obrazów. Główny prompt opisuje tylko to, czego chcesz.
Wyłącz Prompt Enhance
Dopisuje losowe słowa na końcu promptu. Szczegółowy prompt do MOSS-Image jest lepszy w takiej formie, w jakiej go napisałeś.
Uzupełnij ten szablon
Zastąp każdą część w nawiasach kwadratowych własnym pomysłem, a część, której nie potrzebujesz, pomiń.
[Subject doing what] in [setting]. [Other details, each in its place]. [Any text, in double quotes, and where it appears]. [Medium], [camera and framing]. [Light and its source]. [Palette and mood].A street cook in a red apron tosses noodles in a smoking wok at a crowded night market stall. Steam rises past paper lanterns strung overhead; on the left, a line of customers waits under a striped awning. A hand-painted wooden sign above the stall reads "LATE NIGHT NOODLES" in bold yellow letters. Photo, eye level, 35mm, shallow depth of field. Warm light from the lanterns and a cold blue glow from the street behind. Amber and teal palette, busy and cheerful.[Subject doing what]Kogo lub czego dotyczy obraz, razem z akcją: kucharz uliczny w czerwonym fartuchu podrzuca makaron na dymiącym woku.[setting]Gdzie i kiedy: zatłoczone stoisko na nocnym targu.[Other details, each in its place]Wszystko inne w kadrze, z miejscem opisanym słowami: po lewej, nad głową, na pierwszym planie.[Any text, in double quotes, and where it appears]Dokładne słowa i ich wygląd: ręcznie malowany szyld nad stoiskiem z napisem „LATE NIGHT NOODLES”. Pomiń, jeśli nie chcesz tekstu.[Medium]Rodzaj obrazu: zdjęcie, fotografia na kliszy 35 mm, ilustracja akwarelowa, płaski wektorowy plakat.[camera and framing]Skąd patrzymy: z wysokości oczu, szeroki kadr, zbliżenie lekko od dołu.[Light and its source]Co oświetla scenę: ciepłe światło papierowych lampionów zawieszonych nad głową.[Palette and mood]Główne kolory i nastrój: bursztyn i morski turkus, gwarnie i radośnie.
Prompty na start
Napis w prawdziwej scenie
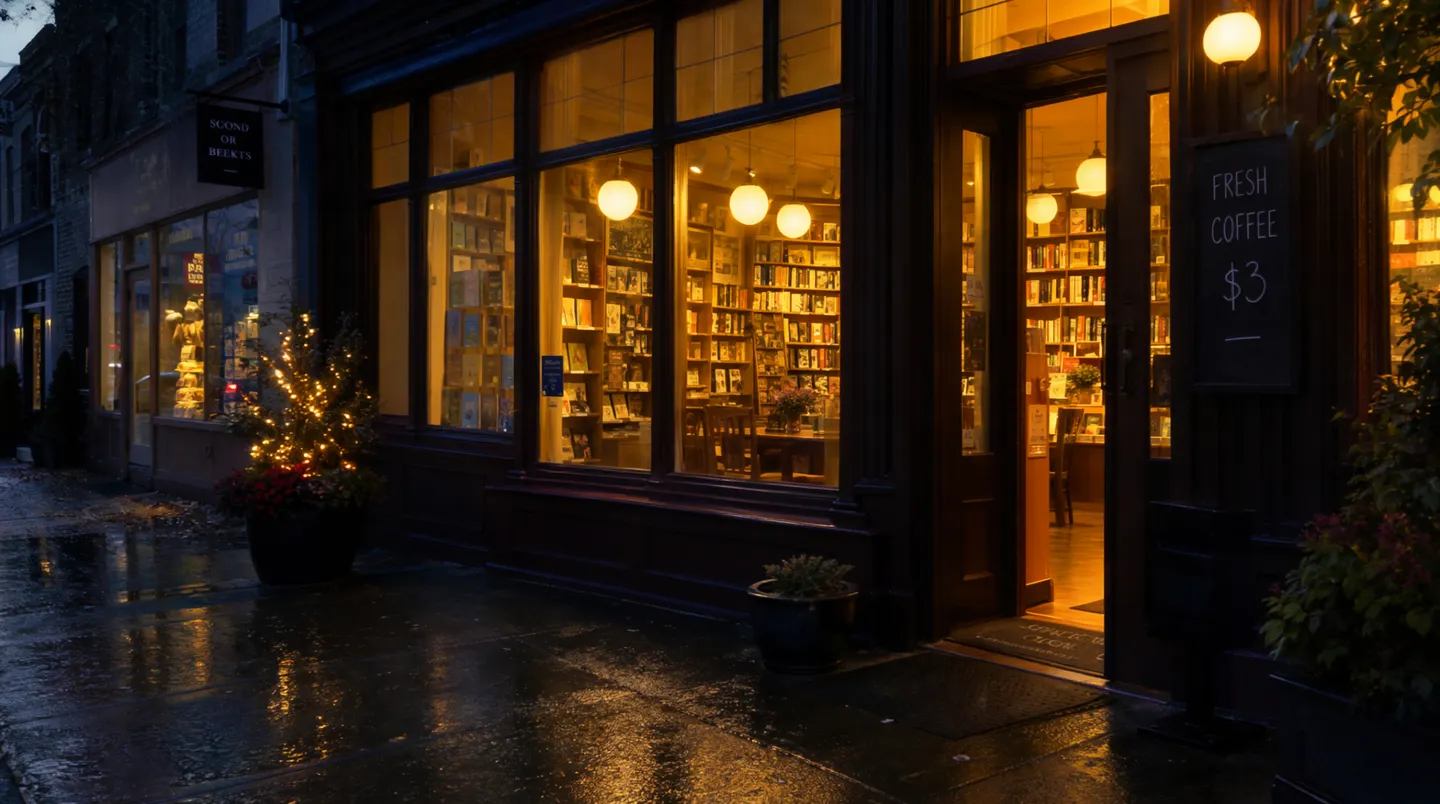
A cozy bookstore cafe at night seen from the rainy street, warm light spilling from tall windows onto wet cobblestones. By the door stands a chalkboard sign that reads "FRESH COFFEE $3" in white hand-lettered capitals. Inside, shelves of books and a few readers at small wooden tables. Photo, eye level, 35mm, soft reflections in the puddles, muted teal street against amber interior light.Dlaczego to działa: Jeden akapit obejmuje całą scenę, słowa z szyldu są zacytowane dokładnie wraz z wyglądem, a kamera, światło i paleta mają swoje nazwy. Pasują do tego proporcje 3:2.
Chińskie pismo odręczne, łamane tam, gdzie chcesz
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small yellow sticky note on the refrigerator door is handwritten in Chinese:
"记得买牛奶和鸡蛋!
牛奶两盒,鸡蛋一打。
顺便带一袋面包。"
Dlaczego to działa: Opis jest po angielsku, a notatka pozostaje po chińsku, z prawdziwym złamaniem wiersza wszędzie tam, gdzie ma się kończyć linijka odręcznego pisma. Notatka brzmi: „Pamiętaj, żeby kupić mleko i jajka! Dwa kartony mleka, tuzin jajek. Weź jeszcze bochenek chleba.”
Szczegółowy portret
An elderly lighthouse keeper in a heavy cable-knit wool sweater stands at the top of a spiral iron staircase, holding a brass oil lamp at chest height. Behind him, the great glass lens of the lighthouse glows gold; through the round, salt-stained windows, storm clouds and white-capped waves roll in at dusk. Weathered face, short gray beard, calm eyes looking just past the camera. 35mm film photograph, medium shot from slightly below, shallow depth of field. Warm lamplight on his face against the cold blue dusk outside. Muted palette of brass, navy, and slate.Dlaczego to działa: Każda część obrazu dostaje własne konkrety, a dwa światła w różnych kolorach budują nastrój przez kontrast, a nie przez słowa o nastroju.
Grafika anime z tagów
best quality, highres, 1girl, solo, long blue hair, twin tails, futuristic stage outfit, holding a microphone, stage lights, cheering crowd in the background, dynamic angleDlaczego to działa: MOSS-Image czyta też tagi w stylu anime: najpierw jakość, potem postać, a na końcu cała reszta. Tagów używaj do grafiki anime, a zdań do wszystkiego innego.
Zaawansowane
Zaawansowane prompty do MOSS-Image
Techniki dające większą kontrolę, gdy podstawy już działają.
Struktura: opis, tagi albo układ
MOSS-Image czyta trzy rodzaje promptów. Opis, czyli ustawienie domyślne, to spójna proza o wszystkim, co widać: postać i akcja, wygląd, miejsce, kamera i kadr, medium, światło, materiały, paleta i nastrój, a położenie rzeczy podane słowami. Tagi to słowa kluczowe w stylu anime, oddzielone przecinkami. Układ to prompt w formacie JSON, który umieszcza każdy blok tekstu i każdy obiekt w osobnym polu, o czym piszemy niżej.
Prozę i strukturę można łączyć, a szczegółowy obraz nie wymaga układu. Sięgnij po niego tylko wtedy, gdy rozmieszczenie musi być dokładne: plakat, menu, kilka paneli albo obiekty, które muszą stać w ustalonych miejscach.
- Zachowaj to, o co prosisz, i uzupełniaj tylko luki: jeśli chcesz akwarelę, dodaj światło, kadr i paletę akwareli, a nie słowa, które ciągną obraz w stronę zdjęcia.
- Pisz tagi w kolejności, w jakiej model się ich nauczył: quality, score, meta, year, character, series, artist, a potem tagi ogólne, takie jak 1girl, blue hair czy stage lights.
- Tag artysty pisz bez @ na początku. Mage odczytuje @ z literami jako zapisany uchwyt, a niezapisany uchwyt zatrzymuje generowanie, zanim zostanie pobrana jakakolwiek opłata.
- Nie dokładaj tagów jakości do opisu. „Masterpiece, 8k, ultra detailed” nie dodaje niczego, czego zwykły opis światła, obiektywu i materiałów nie zrobiłby lepiej.
Tekst na obrazie
Tekst to jedna z mocnych stron MOSS-Image, zarówno po angielsku, jak i po chińsku. Cytuj słowa dokładnie, w ich własnym języku, zachowując wielkie litery, interpunkcję i złamania wierszy, i oddzielaj je od tego, co o nich mówisz: szyld z napisem „OPEN”, a nie „napisz open na szyldzie w zabawny sposób”.
MOSS-Image sam łamie długi tekst na wiersze, i nie zawsze tam, gdzie byś chciał. Wstaw w prompcie prawdziwe złamanie wiersza wszędzie, gdzie linijka ma się kończyć, tak jak w przykładzie z karteczką samoprzylepną wyżej.
- Napisz, jak tekst wygląda i gdzie się znajduje: „dużym, zawijanym pismem kredą u góry”, „małymi, czystymi wersalikami wzdłuż dolnej krawędzi”.
- Zawsze wpisuj prawdziwe słowa, nigdy zastępczych, jak „headline here”: model narysuje wszystko, co jest w cudzysłowie.
- Gdy masz kilka bloków tekstu w stałych miejscach, na przykład plakat z tytułem, datą i miejscem wydarzenia, użyj promptu układu.
Menu na tablicy kredowej z wierszami, nad którymi masz kontrolę
A black chalkboard menu hanging on a white brick wall in a small cafe, hand-lettered in white and yellow chalk. At the top, the title "TODAY" in large looping script. Below it, three lines in neat capitals, one under the other:
"ESPRESSO 3.00
FLAT WHITE 4.50
CHAI LATTE 4.75"
A small chalk drawing of a steaming cup sits in the lower right corner. Photo, straight on, soft daylight from a window on the left.
Dlaczego to działa: Tytuł i trzy wiersze są zacytowane dokładnie i złamane tam, gdzie trzeba, a rysunek ma własny róg, więc słowa go nie zagęszczają.
Prompty układu: osobne pole dla każdego elementu
Prompt układu to eksperymentalny prompt w formacie JSON. Jego pole "summary" opisuje cały obraz i jego styl, a lista "items" zawiera każdy blok tekstu i każdy obiekt z opisem, dokładnymi słowami (dla tekstu) i polem. Wklej go do promptu jako jedną linię.
Pola to współrzędne w pikselach, mierzone od środka obrazu i zapisywane jako góra, lewo, dół, prawo. Najpierw narysuj każde pole w zwykły sposób, od lewego górnego rogu (x1, y1) do prawego dolnego rogu (x2, y2), na obrazie o szerokości W i wysokości H pikseli. Potem odejmij połowę wysokości od każdego y i połowę szerokości od każdego x, a zapisz je w kolejności y1, x1, y2, x2. Na kwadracie 1024 na 1024 tytuł od x 128 do 896 i od y 96 do 224 zamienia się w [-416, -384, -288, 384].
Pola muszą pasować do generowanego obrazu: proporcje 1:1 w rozdzielczości 1K to 1024 na 1024 piksele. Dla innego kształtu najpierw wygeneruj jeden obraz w tych proporcjach i tej rozdzielczości, sprawdź jego szerokość i wysokość, a pola narysuj dla tego rozmiaru.
- Traktuj układ jako swoje źródło: żeby przesunąć tytuł lub zmienić słowo, edytuj tylko ten jeden element i wygeneruj obraz ponownie.
- Dla każdego bloku słów użyj elementu tekstowego, z prawdziwymi słowami w polu "text", a dla każdej rzeczy, która potrzebuje miejsca, elementu obiektu.
- Wyłącz Prompt Enhance i zostaw Prompt Filter pusty: obie funkcje dodają słowa do promptu, a układ musi dotrzeć dokładnie tak, jak został napisany.
- Pola narysowane dla jednych proporcji lub rozdzielczości trafiają w złe miejsca przy innych. Generuj w rozmiarze, dla którego rysowałeś pola.
Plakat podróżniczy, rozmieszczony pole po polu
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}Dlaczego to działa: Podsumowanie ustala cały plakat, tytuł ma dokładne słowo i swoje pole u góry, a góra ma własne pole poniżej. Pola są narysowane dla 1024 na 1024, więc ustaw proporcje 1:1 i rozdzielczość 1K.
Jak zachować tę samą postać
MOSS-Image nie przyjmuje przesyłanych plików, Characters ani References: wszystko pochodzi ze słów. Aby zachować tę samą osobę w całej serii, napisz jeden stały opis (wiek, sylwetka, twarz, włosy, ubiór) i wklejaj go słowo w słowo do każdego promptu, zmieniając tylko zdania o scenie. Ustal też stały Seed.
Aby dopasować się do obrazu, który już masz, albo do zapisanego Character, użyj modelu przyjmującego referencje, takiego jak Mango.
Styl, światło i LoRA
Nazwij medium precyzyjnie: fotografia na kliszy 35 mm, redakcyjny portret studyjny, ilustracja akwarelowa, płaski wektorowy plakat, anime key visual. Następnie opisz światło przez jego źródło i kolor („ciepłe światło lampy na jego twarzy na tle zimnego niebieskiego zmierzchu za oknem”), zamiast używać słów o nastroju.
Dla stylu, którego nie ma model bazowy, dodaj społecznościową LoRA do MOSS-Image w sekcji Model. Zaczyna od siły 0,5: zwiększ ją w stronę 1, jeśli styl ledwo widać, a zmniejsz, jeśli styl zdominuje obiekt.
- Jeśli na stronie LoRA są podane słowa wyzwalające, wpisz je w prompcie.
- Materiały sprawiają, że obraz wygląda realistycznie: szkło z osadem soli, wytarty mosiądz, mokry bruk, sweter z grubego warkocza.
Steps, Guidance Scale i negatywny prompt
Kroki i Guidance Scale mają na starcie wartości z własnej receptury modelu: 50 kroków i guidance 3. Lepiej ich nie ruszać. Mniej kroków działa szybciej, ale gubi szczegóły. Podnieś Guidance Scale do 4–6 tylko wtedy, gdy krótki prompt daje zbyt luźny efekt. Długi, szczegółowy prompt nie potrzebuje więcej niż 3.
Negatywny prompt jest domyślnie pusty. Jeśli ciągle pojawia się coś, czego nie chcesz, zacznij od „worst quality, bad anatomy, watermark, jpeg artifact” i dopisuj kolejne rzeczy. Przy Guidance Scale równym 1 negatywny prompt nic nie robi, dlatego aplikacja go ukrywa.
- Przy tym samym Seed i tych samych ustawieniach ten sam prompt tworzy ten sam obraz. Zmieniaj jedno zdanie naraz, żeby zobaczyć, co robi każde z nich.
Częste błędy
Tego unikaj, a to zrób zamiast tego
Unikaj: Krótki prompt.
coffee shop at night, rain, neon signZamiast tego: Pełny opis: MOSS-Image jest stworzony do długich.
A small corner coffee shop at night seen from across a rainy street. A pink neon sign in the window reads "OPEN LATE" in looping script; inside, a barista wipes the counter under a row of hanging bulbs. Photo, eye level, 35mm, rain streaks catching the neon, deep blue street against warm pink and amber light.Unikaj: Tagi jakości doklejone do promptu zapisanego zdaniami: „masterpiece, 8k, ultra detailed”.
Zamiast tego: Zwykły opis światła, kamery i materiałów.
Unikaj: Tekst zastępczy: „a poster with a headline”.
A concert poster with a headline and the date.Zamiast tego: Prawdziwe słowa w cudzysłowie.
A concert poster with the headline "SUMMER NIGHTS" in tall white letters across the top and "AUGUST 14" in small capitals along the bottom.Unikaj: Łamanie wierszy zostawione modelowi.
Zamiast tego: Prawdziwy podział wiersza w prompcie w każdym miejscu, w którym wiersz tekstu ma się kończyć.
Unikaj: Znak @ przed tagiem artysty.
Zamiast tego: Nazwa artysty bez @ albo styl opisany słowami.
Unikaj: Ramki układu narysowane pod jeden rozmiar, a obraz wygenerowany w innym.
Zamiast tego: Proporcje i rozdzielczość, pod które narysowano ramki.
Unikaj: Włączone Prompt Enhance.
Zamiast tego: Wyłączone ulepszanie promptu: dopisuje losowe słowa do promptu, który napisałeś(-aś) z namysłem.
FAQ
Pytania o prompty do MOSS-Image
Jak długi powinien być prompt dla MOSS-Image?
Czy MOSS-Image radzi sobie z tekstem?
Czy MOSS-Image obsługuje negatywne prompty?
Jak zachować spójną postać w MOSS-Image?
Czym jest prompt układu w MOSS-Image?
Czy prompty do MOSS-Image warto pisać po chińsku?
Czy powinienem(-nam) zmieniać Kroki lub Guidance Scale?
Poradnik promptów
Więcej poradników o promptach
Jak pisać prompty do Anima
Jak pisać prompty do Anima w Mage: kolejność tagów Danbooru, tagi ratingu, mocne wagi, nawiasy z escape'owaniem i przykłady promptów Anima dla postaci i scen.
Jak pisać prompty do Chroma
Poradnik promptów do Chroma: jak pisać prompty do Chroma jednym akapitem w stylu opisu zdjęcia, używać negatywnego promptu, dobierać kroki i skalę prowadzenia oraz kopiować przykłady promptów do Chroma.
Jak pisać prompty do Flux 2
Poradnik promptów do Flux 2: jak pisać prompty do Flux 2 Dev, stosując kolejność z tematem na początku, prompty JSON, dokładne kolory hex i edycję wielu obrazów. Z przykładami.
Jak pisać prompty do GPT Image 2
Poradnik promptów do GPT Image 2: jak pisać prompty do GPT Image 2.5 Flare i Sunburst, by uzyskać dokładny tekst, precyzyjne edycje i spójne postacie – z przykładami.
Jak pisać prompty do Grok Image
Poradnik promptów do Grok Imagine: jak pisać prompty do generatora obrazów Grok Image według zasady xAI „najpierw obiekt”, z pętlą sprawdź i edytuj oraz przykładami promptów do zdjęć do skopiowania.
Jak pisać prompty do Guava
Jak pisać prompty do Guava, modelu fotorealizmu w Mage: szybki start, szablon do uzupełnienia i wskazówki ekspertów dotyczące portretów, skóry, światła, obiektywów, edycji i tekstu.

Stwórz swój pierwszy obraz w MOSS-Image
Nowe konta dostają 300 darmowych Gems, co wystarczy, by wypróbować MOSS-Image. Bez instalacji i bez karty kredytowej.
Wypróbuj MOSS-Image