
Guida ai prompt
Come scrivere prompt per MOSS-Image
Guida ai prompt per MOSS-Image: come scrivere prompt con descrizioni lunghe, testo esatto in inglese e cinese, prompt di layout ed esempi di prompt da copiare.
Guida rapida
Il tuo primo ottimo prompt per MOSS-Image
Tutto quello che serve a chi inizia, in un minuto: cosa sapere prima, le regole più importanti, un modello da compilare e prompt da copiare.
Cosa sapere prima
MOSS-Image è fatto per prompt lunghi e dettagliati: legge un intero paragrafo e lo segue con precisione, quindi un prompt di una riga è sprecato. Descrivi l'immagine con frasi semplici: il soggetto e cosa fa, l'ambiente, la camera, il mezzo espressivo, la luce, i materiali e i colori. Metti tra virgolette doppie le parole che devono comparire nell'immagine. Crea immagini solo da testo, quindi non c'è nulla da caricare, e dimensioni e formato sono impostazioni.
Le regole più importanti
Descrivi tutto
Soggetto e azione, ambiente, camera e inquadratura, mezzo espressivo, luce, materiali e palette. Tutto ciò che non scrivi lo decide MOSS-Image per te, quindi un paragrafo completo vale più di una frase breve.
Metti tra virgolette le parole esatte
Metti il testo tra virgolette doppie, esattamente come deve apparire, con posizione e aspetto: a chalkboard sign by the door that reads "FRESH COFFEE $3" in white hand-lettered capitals.
Scrivi il prompt in inglese
L'inglese dà i risultati migliori. Tieni il testo da riprodurre nella sua lingua dentro le virgolette, per esempio un'insegna di un negozio in cinese dentro una descrizione in inglese.
Usa il prompt negativo per ciò che continua a comparire
Un breve elenco come "worst quality, bad anatomy, watermark, jpeg artifact" ripulisce la maggior parte delle immagini. Il prompt principale descrive solo ciò che vuoi.
Lascia Prompt Enhance disattivato
Aggiunge parole casuali alla fine del prompt. Un prompt dettagliato per MOSS-Image funziona meglio così come l'hai scritto.
Compila questo modello
Sostituisci ogni parte tra parentesi quadre con la tua idea e salta quelle che non ti servono.
[Subject doing what] in [setting]. [Other details, each in its place]. [Any text, in double quotes, and where it appears]. [Medium], [camera and framing]. [Light and its source]. [Palette and mood].A street cook in a red apron tosses noodles in a smoking wok at a crowded night market stall. Steam rises past paper lanterns strung overhead; on the left, a line of customers waits under a striped awning. A hand-painted wooden sign above the stall reads "LATE NIGHT NOODLES" in bold yellow letters. Photo, eye level, 35mm, shallow depth of field. Warm light from the lanterns and a cold blue glow from the street behind. Amber and teal palette, busy and cheerful.[Subject doing what]Chi o cosa è al centro dell'immagine, con l'azione: a street cook in a red apron tosses noodles in a smoking wok.[setting]Dove e quando: a crowded night market stall.[Other details, each in its place]Tutto il resto nell'inquadratura, collocato a parole: on the left, overhead, in the foreground.[Any text, in double quotes, and where it appears]Le parole esatte e il loro aspetto: a hand-painted sign above the stall reads "LATE NIGHT NOODLES". Omettilo se non vuoi testo.[Medium]Che tipo di immagine è: photo, 35mm film photograph, watercolor illustration, flat vector poster.[camera and framing]Da dove guardiamo: eye level, a wide shot, a close-up from slightly below.[Light and its source]Cosa illumina la scena: warm light from paper lanterns overhead.[Palette and mood]I colori principali e la sensazione: amber and teal, busy and cheerful.
Prompt da cui partire
Un'insegna in una scena reale
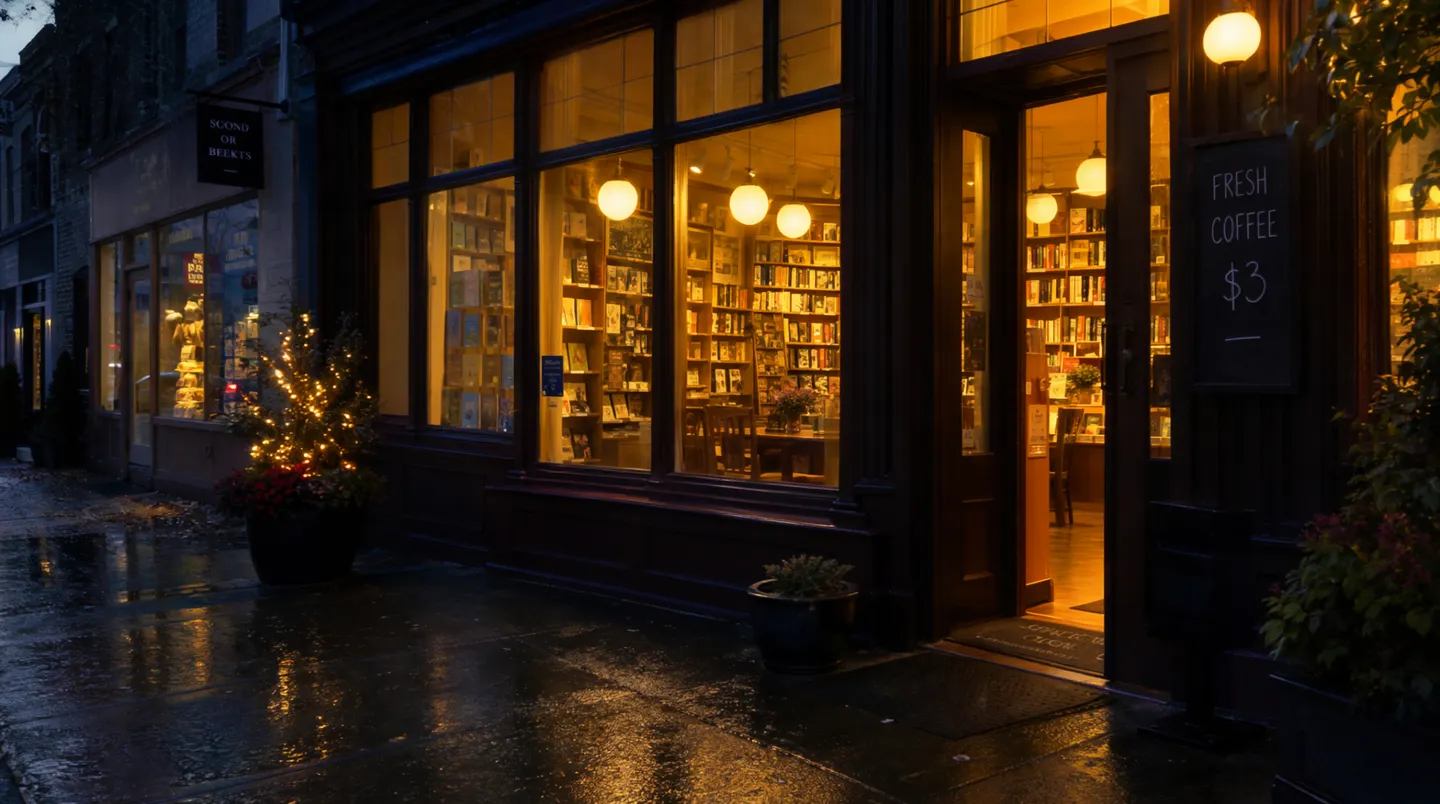
A cozy bookstore cafe at night seen from the rainy street, warm light spilling from tall windows onto wet cobblestones. By the door stands a chalkboard sign that reads "FRESH COFFEE $3" in white hand-lettered capitals. Inside, shelves of books and a few readers at small wooden tables. Photo, eye level, 35mm, soft reflections in the puddles, muted teal street against amber interior light.Perché funziona: Un solo paragrafo copre l'intera scena, le parole dell'insegna sono tra virgolette esatte con il loro aspetto, e camera, luce e palette sono indicate. Un formato 3:2 è adatto.
Cinese scritto a mano, con le interruzioni dove vuoi
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small yellow sticky note on the refrigerator door is handwritten in Chinese:
"记得买牛奶和鸡蛋!
牛奶两盒,鸡蛋一打。
顺便带一袋面包。"
Perché funziona: La descrizione è in inglese e il biglietto resta in cinese, con un vero a capo dove deve finire ogni riga di scrittura a mano. Il biglietto dice: "Ricordati di comprare latte e uova! Due cartoni di latte, una dozzina di uova. Prendi anche un sacchetto di pane."
Un ritratto dettagliato
An elderly lighthouse keeper in a heavy cable-knit wool sweater stands at the top of a spiral iron staircase, holding a brass oil lamp at chest height. Behind him, the great glass lens of the lighthouse glows gold; through the round, salt-stained windows, storm clouds and white-capped waves roll in at dusk. Weathered face, short gray beard, calm eyes looking just past the camera. 35mm film photograph, medium shot from slightly below, shallow depth of field. Warm lamplight on his face against the cold blue dusk outside. Muted palette of brass, navy, and slate.Perché funziona: Ogni parte dell'immagine ha i suoi dettagli, e due luci di colori diversi creano l'atmosfera per contrasto, senza parole generiche sull'umore.
Arte anime dai tag
best quality, highres, 1girl, solo, long blue hair, twin tails, futuristic stage outfit, holding a microphone, stage lights, cheering crowd in the background, dynamic anglePerché funziona: MOSS-Image legge anche i tag in stile anime: prima la qualità, poi il personaggio, poi tutto il resto. Usa i tag per l'arte anime e le frasi per tutto il resto.
Avanzato
Prompt avanzati per MOSS-Image
Tecniche per avere più controllo quando le basi non ti bastano più.
Struttura: una descrizione, dei tag o un layout
MOSS-Image legge tre tipi di prompt. La descrizione, quella predefinita, è una prosa coesa su tutto ciò che si vede: soggetto e azione, aspetto, ambiente, camera e inquadratura, mezzo espressivo, luce, materiali, palette e atmosfera, con la posizione delle cose espressa a parole. I tag sono parole chiave in stile anime separate da virgole. Il layout è un prompt JSON che mette ogni blocco di testo e ogni oggetto in un proprio riquadro, spiegato qui sotto.
Prosa e struttura si possono combinare, e un'immagine dettagliata non ha bisogno di un layout. Usalo solo quando la posizione deve essere esatta: un poster, un menu, più riquadri o oggetti che devono stare in punti precisi.
- Mantieni ciò che hai chiesto e riempi solo i vuoti: se vuoi un acquerello, aggiungi luce, inquadratura e palette tipiche dell'acquerello, non parole che lo spingono verso una foto.
- Scrivi i tag nell'ordine in cui il modello li ha imparati: quality, score, meta, year, character, series, artist, poi i tag generali come 1girl, blue hair o stage lights.
- Scrivi il tag dell'artista senza la @ davanti. Mage legge @ seguita da lettere come un handle salvato, e un handle che non hai salvato blocca la generazione prima di qualsiasi addebito.
- Non accumulare tag di qualità su una descrizione. "Masterpiece, 8k, ultra detailed" non aggiunge nulla che una semplice descrizione di luce, obiettivo e materiali non faccia meglio.
Testo nell'immagine
Il testo è un punto di forza di MOSS-Image, sia in inglese che in cinese. Metti le parole tra virgolette esatte, nella loro lingua, mantenendo maiuscole, punteggiatura e a capo, e tienile separate da ciò che dici su di esse: a sign that reads "OPEN", non "write open on the sign in a fun way".
MOSS-Image divide da solo il testo lungo in righe, e non sempre dove vorresti. Metti un vero a capo nel prompt dove deve finire una riga, come nell'esempio del post-it qui sopra.
- Di' com'è il testo e dove si trova: "in large looping chalk script across the top", "in small clean capitals along the bottom edge".
- Scrivi sempre le parole vere, mai un segnaposto come "headline here": il modello disegna qualsiasi cosa ci sia tra le virgolette.
- Per più blocchi di testo in posizioni fisse, come un poster con titolo, data e luogo, usa un prompt di layout.
Un menu su lavagna con righe sotto il tuo controllo
A black chalkboard menu hanging on a white brick wall in a small cafe, hand-lettered in white and yellow chalk. At the top, the title "TODAY" in large looping script. Below it, three lines in neat capitals, one under the other:
"ESPRESSO 3.00
FLAT WHITE 4.50
CHAI LATTE 4.75"
A small chalk drawing of a steaming cup sits in the lower right corner. Photo, straight on, soft daylight from a window on the left.
Perché funziona: Il titolo e le tre righe sono tra virgolette esatte e spezzati dove devono esserlo, e il disegno ha un suo angolo, così le parole non lo affollano.
Prompt di layout: un riquadro per ogni elemento
Un prompt di layout è un prompt JSON sperimentale. Il suo "summary" descrive l'intera immagine e il suo stile; i suoi "items" elencano ogni blocco di testo e ogni oggetto con una descrizione, le parole esatte per il testo e un riquadro. Incollalo nel prompt su una sola riga.
I riquadri sono coordinate in pixel misurate dal centro dell'immagine, scritte come alto, sinistra, basso, destra. Disegna prima ogni riquadro nel modo consueto, dall'angolo in alto a sinistra (x1, y1) all'angolo in basso a destra (x2, y2), su un'immagine larga W pixel e alta H pixel. Poi sottrai metà dell'altezza da ogni y e metà della larghezza da ogni x, e scrivili nell'ordine y1, x1, y2, x2. Su un quadrato di 1024 per 1024, un titolo da x 128 a 896 e da y 96 a 224 diventa [-416, -384, -288, 384].
I riquadri devono corrispondere all'immagine che generi: il formato 1:1 a risoluzione 1K è di 1024 per 1024 pixel. Per un'altra forma, genera prima un'immagine con quel formato e quella risoluzione, controlla larghezza e altezza e disegna i riquadri per quella dimensione.
- Tieni il layout come sorgente: per spostare il titolo o cambiare una parola, modifica solo quell'elemento e genera di nuovo.
- Usa un elemento di testo per ogni blocco di parole, con le parole vere nel suo campo "text", e un elemento oggetto per ogni cosa che ha bisogno di una posizione.
- Disattiva Prompt Enhance e lascia vuoto il Prompt Filter: entrambi aggiungono parole al prompt, e un layout deve arrivare esattamente come l'hai scritto.
- I riquadri disegnati per un formato o una risoluzione finiscono nei punti sbagliati con un altro. Genera alla dimensione per cui hai disegnato.
Un poster di viaggio, posizionato riquadro per riquadro
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}Perché funziona: Il summary definisce l'intero poster, il titolo ha la sua parola esatta e il suo riquadro in alto, e la montagna ha il proprio riquadro sotto. I riquadri sono disegnati per 1024 per 1024, quindi imposta il formato su 1:1 e la risoluzione su 1K.
Mantenere un personaggio identico
MOSS-Image non accetta caricamenti, Characters né References: tutto nasce dalle parole. Per mantenere identica una persona in una serie, scrivi una descrizione fissa (età, corporatura, viso, capelli, vestiti) e incollala parola per parola in ogni prompt, cambiando solo le frasi sulla scena. Fissa anche il Seed.
Per ottenere un risultato simile a un'immagine che hai già, o a un Character salvato, usa un modello che accetta riferimenti, come Mango.
Stile, luce e LoRA
Indica il mezzo espressivo con precisione: 35mm film photograph, editorial studio portrait, watercolor illustration, flat vector poster, anime key visual. Poi descrivi la luce dalla sua fonte e dal suo colore ("warm lamplight on his face against the cold blue dusk outside") invece di usare parole sull'atmosfera.
Per uno stile che il modello base non ha, aggiungi una LoRA della community per MOSS-Image in Modello. Parte con un'intensità di 0,5: alzala verso 1 se lo stile si vede appena e abbassala se lo stile prende il sopravvento sul soggetto.
- Se la pagina di una LoRA elenca delle parole di attivazione, mettile nel prompt.
- I materiali rendono un'immagine più reale: salt-stained glass, worn brass, wet cobblestones, cable-knit wool.
Steps, Guidance Scale e prompt negativo
Steps e Guidance Scale partono dalla ricetta del modello, 50 step con una guidance di 3, ed è il punto migliore da cui cominciare. Con meno step è più veloce, ma si perde dettaglio. Porta Guidance Scale verso 4-6 solo quando un prompt breve esce troppo vago: un prompt lungo e dettagliato non ha bisogno di più di 3.
Il prompt negativo è vuoto per impostazione predefinita. Quando continua ad apparire qualcosa che non vuoi, parti da "worst quality, bad anatomy, watermark, jpeg artifact" e aggiungi altro. Con una Guidance Scale di 1 il prompt negativo non ha alcun effetto, quindi l'app lo nasconde.
- Con lo stesso Seed e le stesse impostazioni, lo stesso prompt genera la stessa immagine. Cambia una frase alla volta per vedere cosa fa ciascuna.
Errori comuni
Cosa evitare e cosa fare invece
Evita: Un prompt breve.
coffee shop at night, rain, neon signMeglio: Una descrizione completa: MOSS-Image è fatto per quelle lunghe.
A small corner coffee shop at night seen from across a rainy street. A pink neon sign in the window reads "OPEN LATE" in looping script; inside, a barista wipes the counter under a row of hanging bulbs. Photo, eye level, 35mm, rain streaks catching the neon, deep blue street against warm pink and amber light.Evita: Tag di qualità accumulati su un prompt in forma di frase: "masterpiece, 8k, ultra detailed".
Meglio: Una descrizione semplice della luce, della camera e dei materiali.
Evita: Testo segnaposto: "un poster con un titolo".
A concert poster with a headline and the date.Meglio: Le parole vere tra virgolette.
A concert poster with the headline "SUMMER NIGHTS" in tall white letters across the top and "AUGUST 14" in small capitals along the bottom.Evita: Gli a capo lasciati decidere al modello.
Meglio: Un vero a capo nel prompt in ogni punto in cui una riga di testo deve finire.
Evita: Una @ davanti al tag di un artista.
Meglio: Il nome dell'artista senza @, oppure lo stile descritto a parole.
Evita: Riquadri di layout disegnati per un formato e generati in un altro.
Meglio: Le proporzioni e la risoluzione per cui sono stati disegnati i riquadri.
Evita: Prompt Enhance attivo.
Meglio: Prompt Enhance disattivato: aggiunge parole a caso a un prompt che hai scritto con cura.
FAQ
Domande sui prompt per MOSS-Image
Quanto deve essere lungo un prompt per MOSS-Image?
MOSS-Image sa scrivere testo?
MOSS-Image supporta i prompt negativi?
Come mantengo coerente un personaggio in MOSS-Image?
Cos'è un prompt di layout di MOSS-Image?
Devo scrivere i prompt di MOSS-Image in cinese?
Devo cambiare Steps o Guidance Scale?
Guida ai prompt
Altre guide ai prompt
Come scrivere prompt per Anima
Come scrivere i prompt per Anima su Mage: ordine dei tag Danbooru, tag di rating, pesi forti, parentesi con escape ed esempi di prompt per Anima con personaggi e scene.
Come scrivere prompt per Chroma
Guida ai prompt di Chroma: come scrivere prompt per Chroma con un paragrafo in stile didascalia, usare il prompt negativo, regolare step e guidance e copiare esempi di prompt per Chroma.
Come scrivere prompt per Flux 2
Guida ai prompt per Flux 2: come scrivere prompt per Flux 2 Dev con il soggetto all'inizio, prompt JSON, colori esadecimali esatti e modifiche con più immagini, con esempi.
Come scrivere prompt per GPT Image 2
Guida ai prompt per GPT Image 2: come scrivere prompt per GPT Image 2.5 Flare e Sunburst e ottenere testo esatto, modifiche precise e personaggi coerenti, con esempi.
Come scrivere prompt per Grok Image
Guida ai prompt per Grok Imagine: come scrivere prompt per Grok Image con l'ordine "prima il soggetto" di xAI, un ciclo di controllo e modifica ed esempi di prompt per foto da copiare.
Come scrivere prompt per Guava
Come scrivere i prompt per Guava, il modello fotorealistico di Mage: un avvio rapido, un template da compilare e consigli da esperti per ritratti, pelle, luce, obiettivi, modifiche e testo.

Crea la tua prima immagine con MOSS-Image
I nuovi account ricevono 300 Gems gratis, abbastanza per provare MOSS-Image. Nessuna installazione, nessuna carta di credito.
Prova MOSS-Image