
Prompt-Guide
So promptest du MOSS-Image
MOSS-Image Prompt-Guide: So schreibst du Prompts für MOSS-Image mit langen Beschreibungen, exaktem englischem und chinesischem Text, Layout-Prompts und Prompt-Beispielen zum Kopieren.
Schnellstart
Dein erster guter MOSS-Image-Prompt
Alles, was Einsteiger in einer Minute brauchen: was du zuerst wissen solltest, die wichtigsten Regeln, eine Vorlage zum Ausfüllen und Prompts zum Kopieren.
Das solltest du zuerst wissen
MOSS-Image ist für lange, detaillierte Prompts gemacht: Es liest einen ganzen Absatz und setzt ihn genau um, ein einzeiliger Prompt verschenkt also sein Potenzial. Beschreibe das Bild in einfachen Sätzen: das Motiv und was es tut, die Umgebung, die Kamera, das Medium, das Licht, die Materialien und die Farben. Setze Wörter, die im Bild erscheinen sollen, in doppelte Anführungszeichen. Es erzeugt Bilder nur aus Text, du musst also nichts hochladen, und Größe und Format sind Einstellungen.
Die wichtigsten Regeln
Beschreibe alles
Motiv und Handlung, Umgebung, Kamera und Bildausschnitt, Medium, Licht, Materialien und Farbpalette. Was du weglässt, entscheidet MOSS-Image für dich – ein ganzer Absatz ist daher besser als eine kurze Phrase.
Setz den genauen Wortlaut in Anführungszeichen
Setze Text in doppelte Anführungszeichen, genau so, wie er zu lesen sein soll, mit Position und Aussehen: ein Kreidetafel-Schild neben der Tür mit der Aufschrift "FRESH COFFEE $3" in weißen, handgeschriebenen Großbuchstaben.
Schreibe den Prompt auf Englisch
Englisch liefert die besten Ergebnisse. Lass Text, der im Bild stehen soll, in den Anführungszeichen in seiner eigenen Sprache, zum Beispiel ein chinesisches Ladenschild in einer englischen Beschreibung.
Nutze den Negativ-Prompt für das, was immer wieder auftaucht
Eine kurze Liste wie "worst quality, bad anatomy, watermark, jpeg artifact" macht die meisten Bilder sauberer. Der Haupt-Prompt beschreibt nur, was du willst.
Lass Prompt Enhance ausgeschaltet
Es hängt zufällige Wörter an das Ende deines Prompts. Ein detaillierter MOSS-Image-Prompt ist so, wie du ihn geschrieben hast, besser.
Fülle diese Vorlage aus
Ersetze jeden Teil in eckigen Klammern durch deine eigene Idee und lass weg, was du nicht brauchst.
[Subject doing what] in [setting]. [Other details, each in its place]. [Any text, in double quotes, and where it appears]. [Medium], [camera and framing]. [Light and its source]. [Palette and mood].A street cook in a red apron tosses noodles in a smoking wok at a crowded night market stall. Steam rises past paper lanterns strung overhead; on the left, a line of customers waits under a striped awning. A hand-painted wooden sign above the stall reads "LATE NIGHT NOODLES" in bold yellow letters. Photo, eye level, 35mm, shallow depth of field. Warm light from the lanterns and a cold blue glow from the street behind. Amber and teal palette, busy and cheerful.[Subject doing what]Wer oder was im Bild zu sehen ist, mit der Handlung: ein Straßenkoch in roter Schürze wirbelt Nudeln in einem dampfenden Wok.[setting]Wo und wann: ein Stand auf einem belebten Nachtmarkt.[Other details, each in its place]Alles andere im Bild, mit Worten platziert: links, darüber, im Vordergrund.[Any text, in double quotes, and where it appears]Die genauen Wörter und ihr Aussehen: Ein handgemaltes Schild über dem Stand trägt die Aufschrift "LATE NIGHT NOODLES". Lass es weg, wenn kein Text erscheinen soll.[Medium]Um was für ein Bild es sich handelt: Foto, 35-mm-Filmfoto, Aquarell-Illustration, flaches Vektorposter.[camera and framing]Von wo aus wir schauen: auf Augenhöhe, eine Totale, eine Nahaufnahme leicht von unten.[Light and its source]Was die Szene beleuchtet: warmes Licht von Papierlaternen darüber.[Palette and mood]Die Hauptfarben und die Stimmung: Bernstein und Petrol, lebhaft und fröhlich.
Prompts als Ausgangspunkt
Ein Schild in einer realen Szene
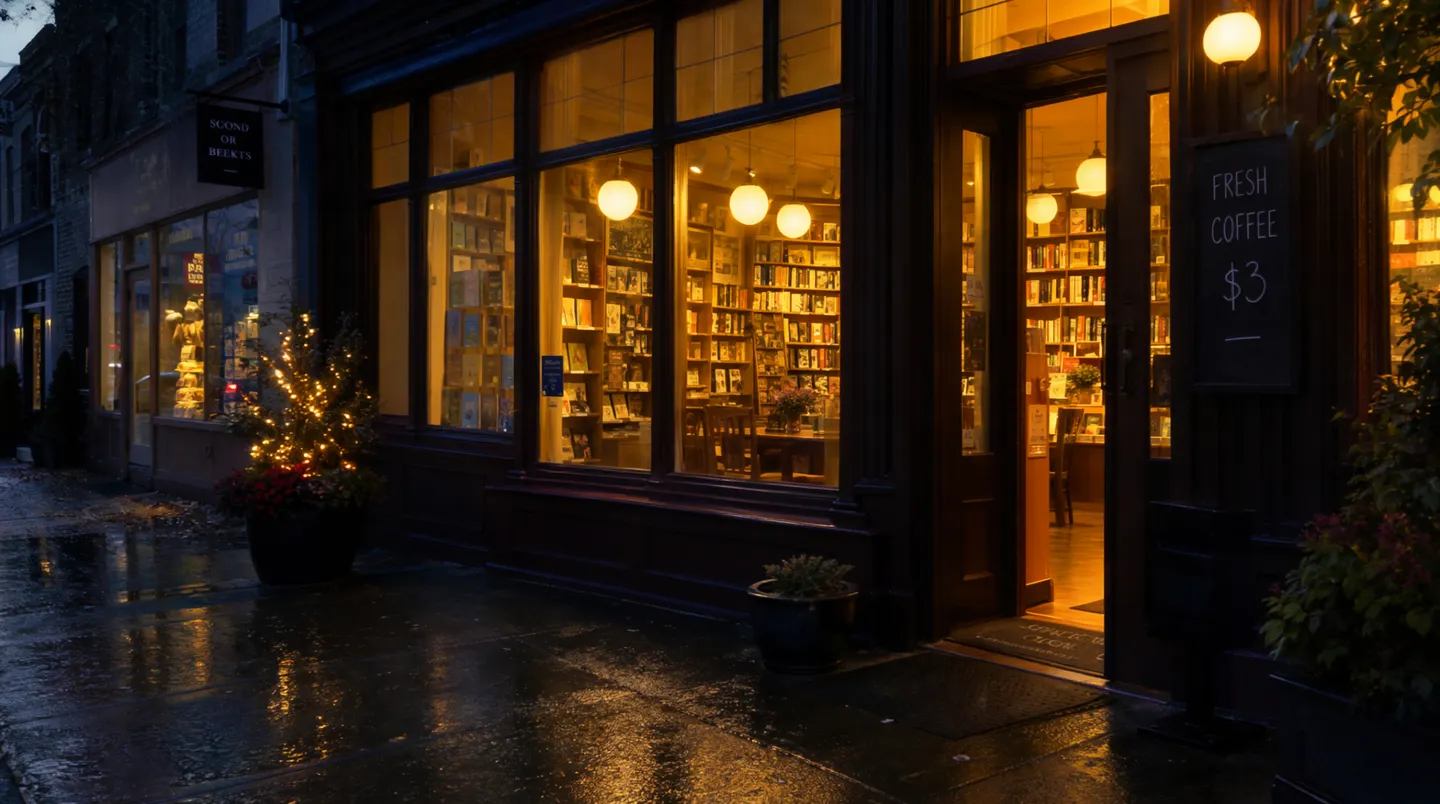
A cozy bookstore cafe at night seen from the rainy street, warm light spilling from tall windows onto wet cobblestones. By the door stands a chalkboard sign that reads "FRESH COFFEE $3" in white hand-lettered capitals. Inside, shelves of books and a few readers at small wooden tables. Photo, eye level, 35mm, soft reflections in the puddles, muted teal street against amber interior light.Warum das funktioniert: Ein Absatz deckt die ganze Szene ab, der Text auf dem Schild steht exakt in Anführungszeichen samt Aussehen, und Kamera, Licht und Farbpalette sind benannt. Das Seitenverhältnis 3:2 passt dazu.
Handgeschriebenes Chinesisch, umgebrochen, wo du willst
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small yellow sticky note on the refrigerator door is handwritten in Chinese:
"记得买牛奶和鸡蛋!
牛奶两盒,鸡蛋一打。
顺便带一袋面包。"
Warum das funktioniert: Die Beschreibung ist auf Englisch, die Notiz bleibt auf Chinesisch, mit einem echten Zeilenumbruch überall dort, wo eine Zeile der Handschrift enden soll. Die Notiz lautet: "Remember to buy milk and eggs! Two cartons of milk, a dozen eggs. Pick up a bag of bread too."
Ein detailliertes Porträt
An elderly lighthouse keeper in a heavy cable-knit wool sweater stands at the top of a spiral iron staircase, holding a brass oil lamp at chest height. Behind him, the great glass lens of the lighthouse glows gold; through the round, salt-stained windows, storm clouds and white-capped waves roll in at dusk. Weathered face, short gray beard, calm eyes looking just past the camera. 35mm film photograph, medium shot from slightly below, shallow depth of field. Warm lamplight on his face against the cold blue dusk outside. Muted palette of brass, navy, and slate.Warum das funktioniert: Jeder Teil des Bildes bekommt seine eigenen Fakten, und zwei Lichter in unterschiedlichen Farben erzeugen die Stimmung durch Kontrast statt durch Stimmungswörter.
Anime-Art aus Tags
best quality, highres, 1girl, solo, long blue hair, twin tails, futuristic stage outfit, holding a microphone, stage lights, cheering crowd in the background, dynamic angleWarum das funktioniert: MOSS-Image versteht auch Tags im Anime-Stil: zuerst die Qualität, dann die Figur, dann alles andere. Nutze Tags für Anime-Art und Sätze für alles andere.
Fortgeschritten
Fortgeschrittenes Prompting mit MOSS-Image
Techniken für mehr Kontrolle, sobald die Grundlagen sitzen.
Struktur: Beschreibung, Tags oder Layout
MOSS-Image versteht drei Arten von Prompts. Eine Beschreibung (Caption), die Standardform, ist zusammenhängender Fließtext über alles, was man sieht: Motiv und Handlung, Aussehen, Umgebung, Kamera und Bildausschnitt, Medium, Licht, Materialien, Farbpalette und Stimmung, wobei die Positionen in Worten angegeben werden. Tags sind durch Kommas getrennte Schlüsselwörter im Anime-Stil. Ein Layout ist ein JSON-Prompt, der jeden Textblock und jedes Objekt in eine eigene Box setzt, mehr dazu unten.
Fließtext und Struktur lassen sich kombinieren, und ein detailliertes Bild braucht kein Layout. Greife nur dann darauf zurück, wenn die Platzierung exakt sein muss: bei einem Poster, einer Speisekarte, mehreren Panels oder Objekten, die an festen Stellen sitzen sollen.
- Behalte, worum du gebeten hast, und fülle nur die Lücken: Wenn du ein Aquarell willst, ergänze Licht, Bildausschnitt und Farbpalette eines Aquarells, nicht Wörter, die es in Richtung Foto ziehen.
- Schreibe Tags in der Reihenfolge, in der das Modell sie gelernt hat: Qualität, Score, Meta, Jahr, Figur, Serie, Künstler, dann allgemeine Tags wie 1girl, blue hair oder stage lights.
- Schreibe einen Künstler-Tag ohne das @ davor. Mage liest @ gefolgt von Buchstaben als gespeicherten Handle, und ein nicht gespeicherter Handle stoppt die Generierung, bevor etwas berechnet wird.
- Stapele keine Qualitäts-Tags auf eine Beschreibung. "Masterpiece, 8k, ultra detailed" bringt nichts, was eine schlichte Beschreibung von Licht, Objektiv und Materialien nicht besser leistet.
Text im Bild
Text ist eine besondere Stärke von MOSS-Image, auf Englisch und auf Chinesisch. Setze die Wörter exakt in Anführungszeichen, in ihrer eigenen Sprache, mit Großschreibung, Satzzeichen und Zeilenumbrüchen, und halte sie getrennt von dem, was du über sie sagst: ein Schild mit der Aufschrift "OPEN", nicht "write open on the sign in a fun way".
MOSS-Image bricht langen Text selbst in Zeilen um, und nicht immer dort, wo du es willst. Setze im Prompt einen echten Zeilenumbruch überall dort, wo eine Zeile enden soll, wie im Haftnotiz-Beispiel oben.
- Beschreibe, wie der Text aussieht und wo er sitzt: "in large looping chalk script across the top", "in small clean capitals along the bottom edge".
- Schreibe immer die echten Wörter, nie einen Platzhalter wie "headline here": Das Modell zeichnet alles, was in den Anführungszeichen steht.
- Für mehrere Textblöcke an festen Stellen, etwa bei einem Poster mit Titel, Datum und Veranstaltungsort, nimm einen Layout-Prompt.
Eine Kreidetafel-Speisekarte mit Zeilen, die du steuerst
A black chalkboard menu hanging on a white brick wall in a small cafe, hand-lettered in white and yellow chalk. At the top, the title "TODAY" in large looping script. Below it, three lines in neat capitals, one under the other:
"ESPRESSO 3.00
FLAT WHITE 4.50
CHAI LATTE 4.75"
A small chalk drawing of a steaming cup sits in the lower right corner. Photo, straight on, soft daylight from a window on the left.
Warum das funktioniert: Der Titel und die drei Zeilen stehen exakt in Anführungszeichen und sind dort umgebrochen, wo sie umbrechen sollen, und die Zeichnung hat ihre eigene Ecke, damit die Wörter sie nicht bedrängen.
Layout-Prompts: eine Box für jedes Element
Ein Layout-Prompt ist ein experimenteller JSON-Prompt. Sein "summary" beschreibt das ganze Bild und seinen Stil; seine "items" listen jeden Textblock und jedes Objekt mit einer Beschreibung, den genauen Wörtern für Text und einer Box auf. Füge ihn als eine einzige Zeile in den Prompt ein.
Boxen sind Pixelkoordinaten, vom Bildmittelpunkt aus gemessen und in der Reihenfolge oben, links, unten, rechts geschrieben. Zeichne jede Box zuerst wie gewohnt von der oberen linken Ecke (x1, y1) bis zur unteren rechten Ecke (x2, y2) in einem Bild, das W Pixel breit und H Pixel hoch ist. Ziehe dann von jedem y die halbe Höhe und von jedem x die halbe Breite ab und schreibe sie in der Reihenfolge y1, x1, y2, x2. Auf einem Quadrat von 1024 mal 1024 wird ein Titel von x 128 bis 896 und von y 96 bis 224 zu [-416, -384, -288, 384].
Die Boxen müssen zum erzeugten Bild passen: Das Seitenverhältnis 1:1 bei 1K-Auflösung ist 1024 mal 1024 Pixel. Für ein anderes Format erzeuge zuerst ein Bild mit diesem Seitenverhältnis und dieser Auflösung, prüfe Breite und Höhe und zeichne deine Boxen für diese Größe.
- Behalte das Layout als deine Vorlage: Um den Titel zu verschieben oder ein Wort zu ändern, bearbeite nur dieses eine Element und generiere erneut.
- Nutze für jeden Textblock ein Text-Element mit den echten Wörtern im Feld "text" und für jedes Ding, das einen Platz braucht, ein Objekt-Element.
- Schalte Prompt Enhance aus und lass den Prompt Filter leer: Beide fügen dem Prompt Wörter hinzu, und ein Layout muss genau so ankommen, wie es geschrieben ist.
- Boxen, die für ein Seitenverhältnis oder eine Auflösung gezeichnet wurden, landen bei einem anderen an den falschen Stellen. Generiere in der Größe, für die du gezeichnet hast.
Ein Reiseposter, Box für Box platziert
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}Warum das funktioniert: Die Zusammenfassung legt das ganze Poster fest, der Titel hat sein exaktes Wort und seine Box oben, und der Berg hat seine eigene Box darunter. Die Boxen sind für 1024 mal 1024 gezeichnet, stelle also das Seitenverhältnis auf 1:1 und die Auflösung auf 1K.
Eine Figur gleich halten
MOSS-Image akzeptiert keine Uploads, Characters oder References: Alles entsteht aus den Worten. Um eine Person in einer Serie gleich zu halten, schreibe eine feste Beschreibung von ihr (Alter, Statur, Gesicht, Haare, Kleidung) und füge sie Wort für Wort in jeden Prompt ein, wobei du nur die Sätze über die Szene änderst. Fixiere auch den Seed.
Um ein vorhandenes Bild oder einen gespeicherten Character nachzubilden, nutze ein Modell, das Referenzen akzeptiert, wie Mango.
Stil, Licht und LoRAs
Benenne das Medium präzise: 35-mm-Filmfoto, redaktionelles Studioporträt, Aquarell-Illustration, flaches Vektorposter, Anime-Key-Visual. Beschreibe dann das Licht nach Quelle und Farbe ("warm lamplight on his face against the cold blue dusk outside") statt mit Stimmungswörtern.
Für einen Stil, den das Basismodell nicht kennt, füge unter Modell eine MOSS-Image-LoRA aus der Community hinzu. Sie startet mit einer Stärke von 0,5; erhöhe sie Richtung 1, wenn der Stil kaum zu sehen ist, und senke sie, wenn der Stil das Motiv überlagert.
- Wenn auf der Seite einer LoRA Trigger-Wörter aufgelistet sind, nimm sie in den Prompt auf.
- Materialien lassen ein Bild echt wirken: salzverkrustetes Glas, abgenutztes Messing, nasses Kopfsteinpflaster, Zopfstrick-Wolle.
Steps, Guidance Scale und der Negativ-Prompt
Steps und Guidance Scale starten mit dem Rezept des Modells selbst: 50 Steps bei einer Guidance von 3. Das ist die beste Einstellung dafür. Weniger Steps laufen schneller, aber es gehen Details verloren. Erhöhe die Guidance Scale nur dann auf 4 bis 6, wenn ein kurzer Prompt zu vage ausfällt; ein langer, detaillierter Prompt braucht nicht mehr als 3.
Der Negativ-Prompt ist standardmäßig leer. Wenn immer wieder etwas auftaucht, das du nicht willst, starte mit „worst quality, bad anatomy, watermark, jpeg artifact“ und ergänze es. Bei einer Guidance Scale von 1 hat der Negativ-Prompt keine Wirkung, deshalb blendet die App ihn aus.
- Mit demselben Seed und denselben Einstellungen erzeugt derselbe Prompt dasselbe Bild. Ändere jeweils nur einen Satz, um zu sehen, was er bewirkt.
Häufige Fehler
Das besser vermeiden, stattdessen so
Vermeiden: Ein kurzer Prompt.
coffee shop at night, rain, neon signBesser: Eine vollständige Beschreibung: MOSS-Image ist für lange gemacht.
A small corner coffee shop at night seen from across a rainy street. A pink neon sign in the window reads "OPEN LATE" in looping script; inside, a barista wipes the counter under a row of hanging bulbs. Photo, eye level, 35mm, rain streaks catching the neon, deep blue street against warm pink and amber light.Vermeiden: Qualitäts-Tags, die auf einen Prompt aus ganzen Sätzen gestapelt werden: „masterpiece, 8k, ultra detailed“.
Besser: Eine schlichte Beschreibung von Licht, Kamera und Materialien.
Vermeiden: Platzhaltertext: „ein Poster mit einer Schlagzeile“.
A concert poster with a headline and the date.Besser: Die echten Wörter in Anführungszeichen.
A concert poster with the headline "SUMMER NIGHTS" in tall white letters across the top and "AUGUST 14" in small capitals along the bottom.Vermeiden: Zeilenumbrüche dem Modell überlassen.
Besser: Ein echter Zeilenumbruch im Prompt überall dort, wo eine Textzeile enden soll.
Vermeiden: Ein @ vor einem Künstler-Tag.
Besser: Der Künstlername ohne @ oder der Stil in Worten beschrieben.
Vermeiden: Layout-Boxen, die für eine Größe gezeichnet und in einer anderen generiert wurden.
Besser: Das Seitenverhältnis und die Auflösung, für die die Boxen gezeichnet wurden.
Vermeiden: Prompt Enhance eingeschaltet.
Besser: Prompt Enhance aus: Es hängt zufällige Wörter an einen Prompt an, den du sorgfältig geschrieben hast.
FAQ
Fragen zum Prompten mit MOSS-Image
Wie lang sollte ein MOSS-Image-Prompt sein?
Kann MOSS-Image Text darstellen?
Unterstützt MOSS-Image Negativ-Prompts?
Wie halte ich eine Figur in MOSS-Image konsistent?
Was ist ein MOSS-Image-Layout-Prompt?
Sollte ich MOSS-Image-Prompts auf Chinesisch schreiben?
Sollte ich Steps oder Guidance Scale ändern?
Prompt-Guide
Weitere Prompt-Guides
So promptest du Anima
So schreibst du Prompts für Anima auf Mage: Reihenfolge der Danbooru-Tags, Rating-Tags, starke Gewichtung, maskierte Klammern und Anima-Prompt-Beispiele für Charaktere und Szenen.
So promptest du Chroma
Chroma-Prompt-Guide: So schreibst du Prompts für Chroma, den KI-Bildgenerator, in einem Absatz im Bildunterschrift-Stil, nutzt den Negativ-Prompt, stellst Steps und Guidance ein und kopierst Chroma-Prompt-Beispiele.
So promptest du Flux 2
Flux 2 Prompt-Guide: So schreibst du Prompts für Flux 2 Dev – mit Motiv zuerst, JSON-Prompts, exakten Hex-Farben und Bearbeitung mehrerer Bilder, inklusive Beispielen.
So promptest du GPT Image 2
GPT Image 2 Prompt-Guide: So schreibst du Prompts für GPT Image 2.5 Flare und Sunburst für exakten Text, präzise Bearbeitungen und konsistente Figuren, mit Beispielen.
So promptest du Grok Image
Prompt-Guide für Grok Imagine: So schreibst du Prompts für Grok Image mit der Subjekt-zuerst-Reihenfolge von xAI, einem Prüfen-dann-Bearbeiten-Ablauf und kopierbaren Beispiel-Prompts für Fotos.
So promptest du Guava
So schreibst du Prompts für Guava, das Fotorealismus-Modell von Mage: Schnellstart, Vorlage zum Ausfüllen und Profi-Tipps für Porträts, Haut, Licht, Objektive, Bearbeitungen und Text.

Erstelle dein erstes Bild mit MOSS-Image
Neue Accounts erhalten 300 Gems gratis, genug, um MOSS-Image auszuprobieren. Ohne Installation, ohne Kreditkarte.
MOSS-Image ausprobieren